

はじめに
すべてのシステムアナリストおよびソフトウェア設計者は、曖昧で断片的な顧客要件を明確で実行可能な技術仕様書に変換することの苦痛を知っています。無数のフローチャートや何ページにもわたるドキュメントを作成しても、開発者から「機能の開始点や終了点はどこか」「データが特定のモジュールとどう関連するか」といった混乱した反応が返ってくるかもしれません。このコミュニケーションのギャップが、プロジェクトの遅延と手戻りの主な原因となっています。
解決策はドキュメントを増やすことではなく、より良い構造化された可視化です。階層型データフロー図(DFD) 複雑なシステムを解剖するための決定的な「メス」として機能します。一般的なフローチャートとは異なり、DFDはデータの変換と移動に厳密に焦点を当て、認知的負荷を効果的に管理するトップダウン分解戦略を用います。
この包括的なガイドは理論を超え、階層型DFDを習得するための実戦で検証されたフレームワークを提供します。プロダクトマネージャー、システムアナリスト、または開発者であるかどうかにかかわらず、このガイドは、混沌とした要件を正確で実行可能な設計図へと変換するための手法をあなたに備え付けます。
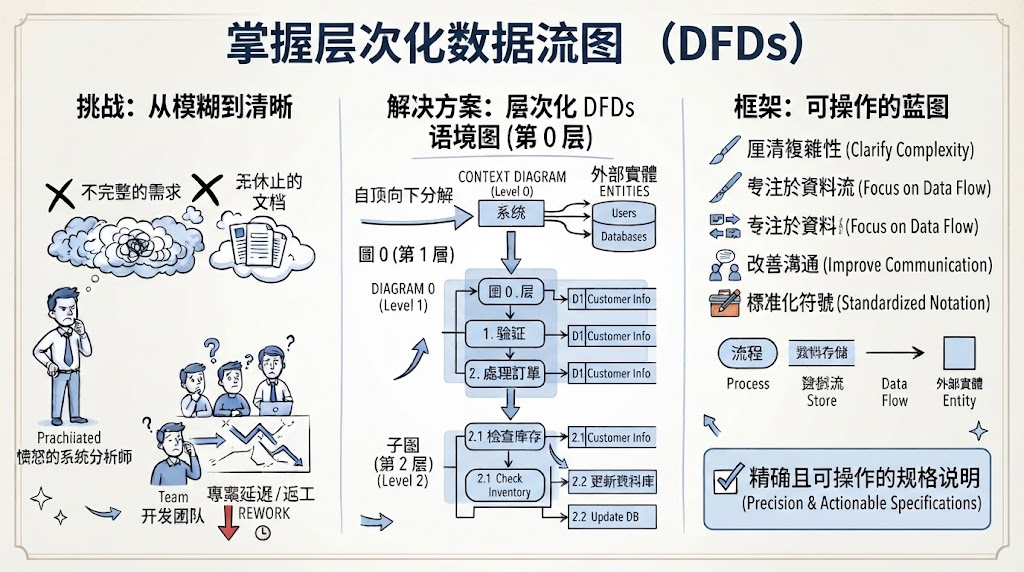
ビジュアルアセットに関する注記:このテキストベースのガイドは元の内容を再構築したものであるため、セクション3および4で言及されている具体的な図については、元のソース資料を参照してください。以下のテキストによる説明は、それらの視覚的な例と完全に一致するように設計されています。
主要概念の概要
描画プロセスに入る前に、これらの基礎的な概念を心に刻んでください:
| 概念 | 定義 | なぜ重要なのか |
|---|---|---|
| 分解 | 複雑なシステムを管理可能なネストされた層に分割すること。 | 認知的負荷の過剰を防ぎ、チームによる並列分析を可能にします。 |
| 抽象化 | 上位レベルのインターフェースの背後に、下位レベルの実装詳細を隠すこと。 | 関係者が関連する詳細レベルに集中することを可能にします。 |
| バランスの原則 | 親図と子図の間で、入力/出力データの流れが正確に一致していることを保証すること。 | 論理的整合性を保証し、「データの漏洩」を防ぎます。 |
| 7±2の法則 | 1 つの図あたりのプロセス数を 5〜9 要素に制限する。 | 可読性を高めるために、人間の短期記憶の容量に合致させる。 |
| 機能的凝集 | 同じ中核データオブジェクトを操作するサブプロセスをグループ化する。 | 保守可能で緩く結合されたシステムモジュールを作成する。 |
1. レイヤー化の哲学:なぜ巨大な 1 つの地図にしないのか?
エンタープライズシステム全体を 1 つの図に収めようとする試みは、エンジニアリングのアンチパターンである。階層化 DFD(データフロー図)は、人間の認知能力とソフトウェアの保守性という 2 つの根本的な制約のために存在する。
認知の限界
認知心理学の研究により、人間は同時に 5〜9 の情報チャンクしか効果的に処理できないことが示されている。数百ノードを持つ単一のモノリシックな図はこの限界に違反し、コミュニケーション手段として無効となる。レイヤー化は、一度に 1 つの整合性のある抽象化レベルを示すことで、この境界を尊重する。
エンジニアリング上の利点
-
複雑性の制御:読者は、圧倒されるような地図ではなく、シンプルで焦点を絞った図を消化する。
-
並行作業ストリーム:異なるチームが、頻繁なマージ競合なしに、異なるレイヤーやモジュールを所有できる。
-
変更の隔離:変更は通常、特定のレイヤーとその直下の子要素にのみ影響し、影響分析を予測可能にする。
-
アジャイルとの整合:トップダウンでの洗練は反復開発を反映し、詳細が進化する一方で高レベル設計を安定させることができる。
DFD 記法の 4 つの柱
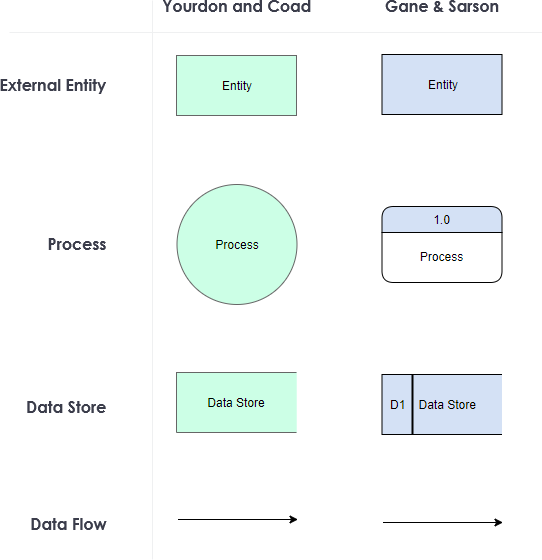
これらをレゴブロックのように考えてください。これらを誤解すると、必ず欠陥のあるモデルになります。
-
外部エンティティ(四角形/長方形):データのソースまたは宛先システム境界の外側(例:顧客、決済ゲートウェイ)。ルール:それらの動作を変更することはできません。それらとのインターフェースを定義するだけです。
-
プロセス(角丸長方形/円):データの変換。すべてのプロセスには入力と出力の両方が必要です。ルール: プロセスは、計算、検証、フィルタリング、または集約を通じてデータの状態を変更します。
-
データストア(開いた長方形/平行線): 静的なリポジトリ(データベース、ファイル、キャッシュ)。ルール: 時間の経過に伴うデータの永続性を表します。プロセスはストアから読み取り、ストアに書き込みます。
-
データフロー(矢印付き線): エンティティ、プロセス、およびストア間でのデータパケットの移動。ルール: 名詞句でラベル付けする必要があります(例:「注文詳細」であり、「注文の送信」ではありません)。フローはデータを表すものであり、物理的なオブジェクトや純粋な制御信号を表すものではありません。
2. 段階的な描画手法
階層的なDFD(データフロー図)を作成することは、規律ある順次プロセスです。各ステップには特定の検証基準があります。
ステップ1:コンテキスト図(最上位レベル)
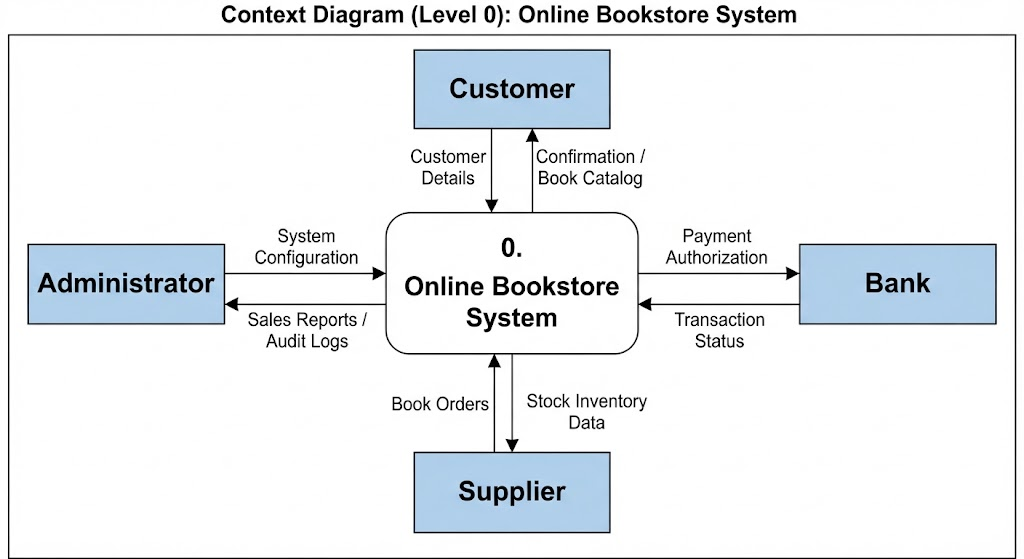
目的: システムの境界と外部インターフェースを定義します。これはシステムの「憲法」です。
-
システム全体を表す単一の中央プロセスを描画します。
-
システムと相互作用するすべての外部エンティティを特定します。
-
エンティティと中央プロセスを、ラベル付きのデータフローで接続します。
-
重要な制約:外部エンティティ間でデータフローが直接発生してはなりません。すべての相互作用はシステムを経由する必要があります。このレベルではデータストアは表示されません。
[元の画像を挿入:コンテキスト図の例 – オンライン書店システム]
実用的なヒント:データフローには名詞句を使用してください。「支払い情報」は正しく、「支払い処理」は誤りです。すべての後続のレイヤーにわたって外部エンティティの名前が統一されていることを確認してください。
ステップ2:レベル0図(システム概要)
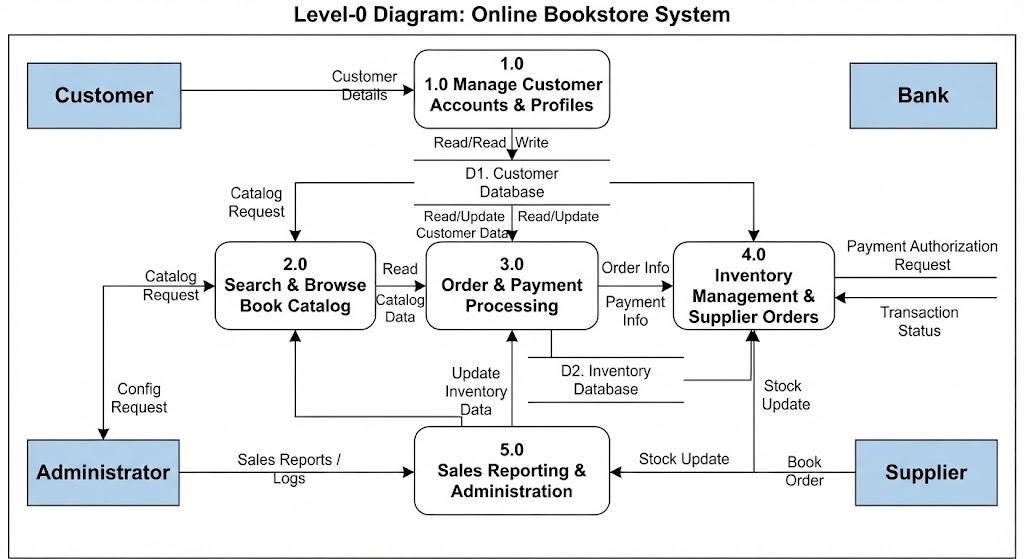
目的:中央プロセスを主要な機能的サブシステムに分解します。
-
中央プロセスを、中核的なビジネス機能を表す3〜7の主要なサブプロセスに分解します。
-
コンテキスト図からすべての外部エンティティを保持します。
-
バランスチェック: コンテキスト図からのすべての入力/出力フローは、レベル 0 のサブプロセスと正確に一致しなければなりません。データが新たに現れたり消えたりしてはなりません。
-
複数のプロセスに共通して使用される内部データストアを導入する。
[元画像の挿入:レベル 0 ダイアグラム例 – オンライン書店システム]
検証: 行ごとの監査を実行する。コンテキスト図に「顧客 → システム:注文情報」が表示されている場合、レベル 0 には「顧客 → プロセス 3.0:注文情報」と表示されなければならない。フローの欠落や余分なフローは分解エラーを示す。
ステップ 3:下位レベルのダイアグラム(段階的詳細化)
目標: 各プロセスが「機能素子」のステータスに達するまで、複雑なレベル 0 のプロセスを分解する。これは擬似コードや意思決定表で記述できるほど単純である必要がある。
-
子ダイアグラムには、親プロセスの番号を付与する(例:プロセス 3.0 はダイアグラム 3 に展開される)。
-
親の入力/出力をすべて正確に継承する。
-
必要に応じて内部データフローとローカルデータストアを追加する。
-
プロセスが単一の関数またはメソッドとして実装できる場合に、分解を停止する。
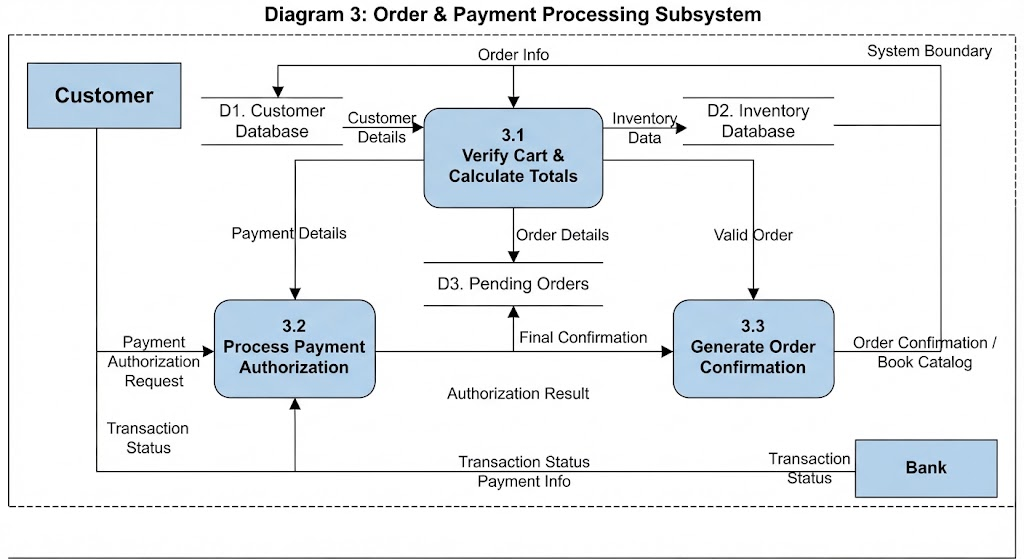
避けるべき一般的なアンチパターン
| アンチパターン | 説明 | 修正 |
|---|---|---|
| ブラックホール | プロセスに入力は存在するが、出力がない。 | 欠落している出力を特定する:エラーメッセージ、ログエントリ、またはステータス更新。 |
| ミラクル | プロセスに出力は存在するが、入力がない。 | データの起源を追跡する:入力フローの欠落、または未読のデータストア。 |
| グレーホール | 入力が、記載された出力を生成するのに不十分である。 | 欠落している入力データフローまたはデータストアの読み込みを追加する。 |
| ストア間フロー | 2 つのデータストア間の直接矢印。 | ストア間にプロセスを挿入する。データ移動には変換が必要である。 |
| エンティティ間フロー | 外部エンティティ間の直接矢印。 | DFDから削除します。これはシステム範囲外で発生します。 |
3. 統合ケーススタディ:図書館貸出システム
すべての概念を統合するために、完全な図書館システムの例をたどります。(以下に説明する各層の視覚的表現については、元の画像を参照してください。)
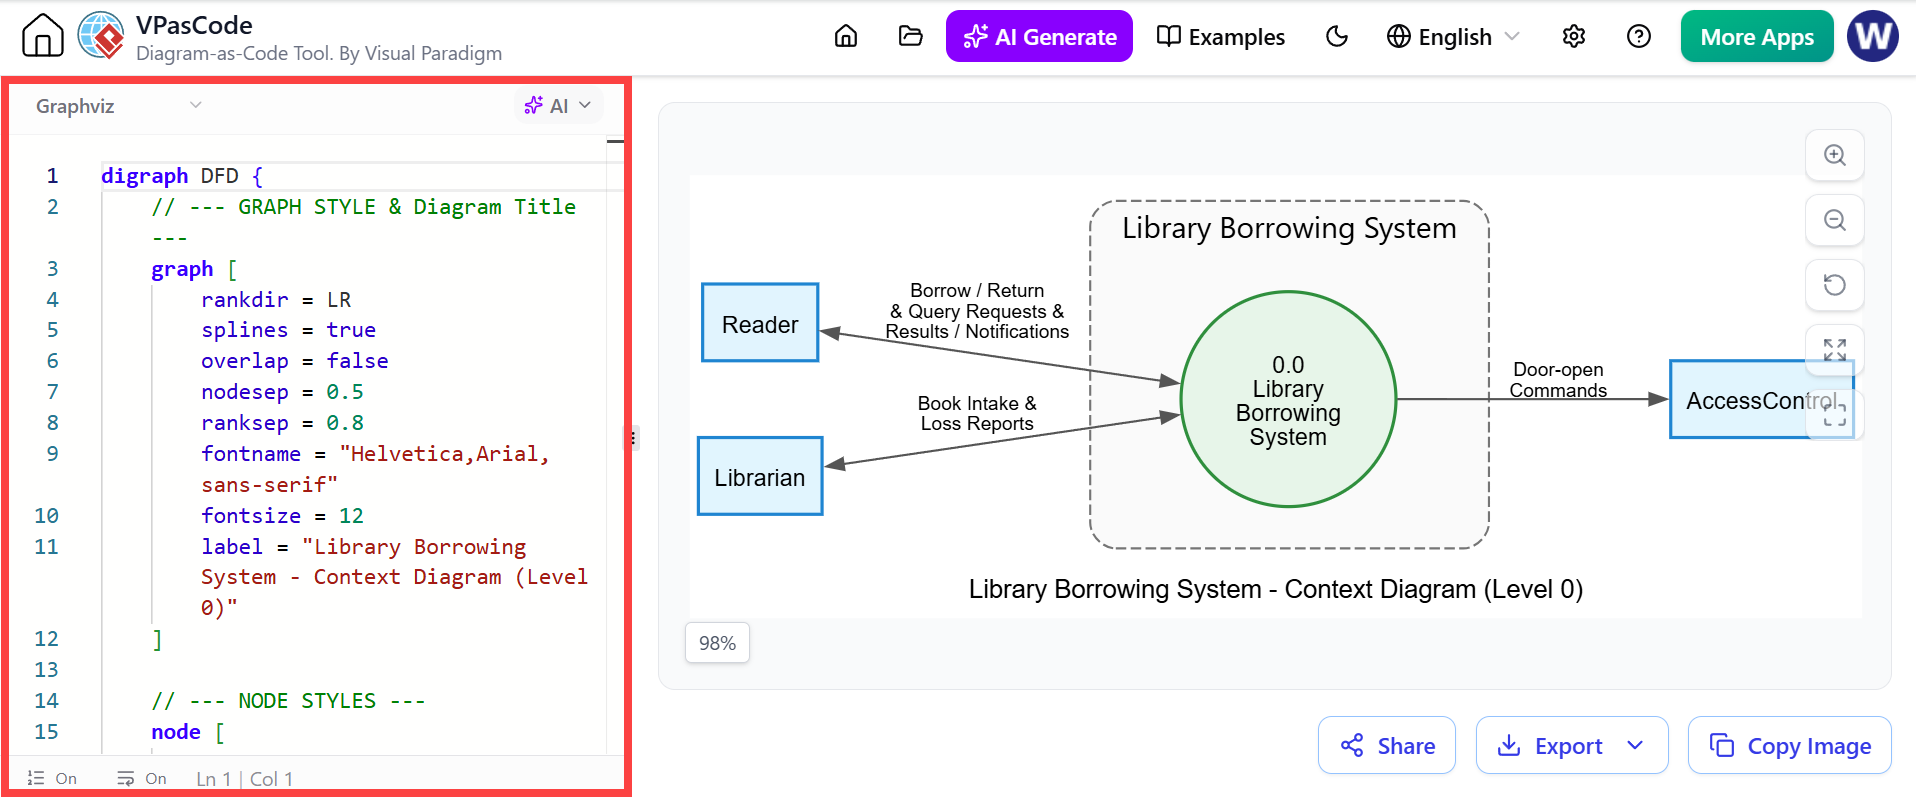
コンテキスト図:境界定義
システム:図書館貸出システム
-
外部エンティティ:読者、司書、アクセス制御システム(外部ハードウェア)
-
主要フロー:読者が貸出・返却・照会リクエストを提出します。システムは結果と通知を返します。司書は書籍受入と紛失報告を提供します。システムは貸出が成功した場合、アクセス制御にドア開放コマンドを送信します。
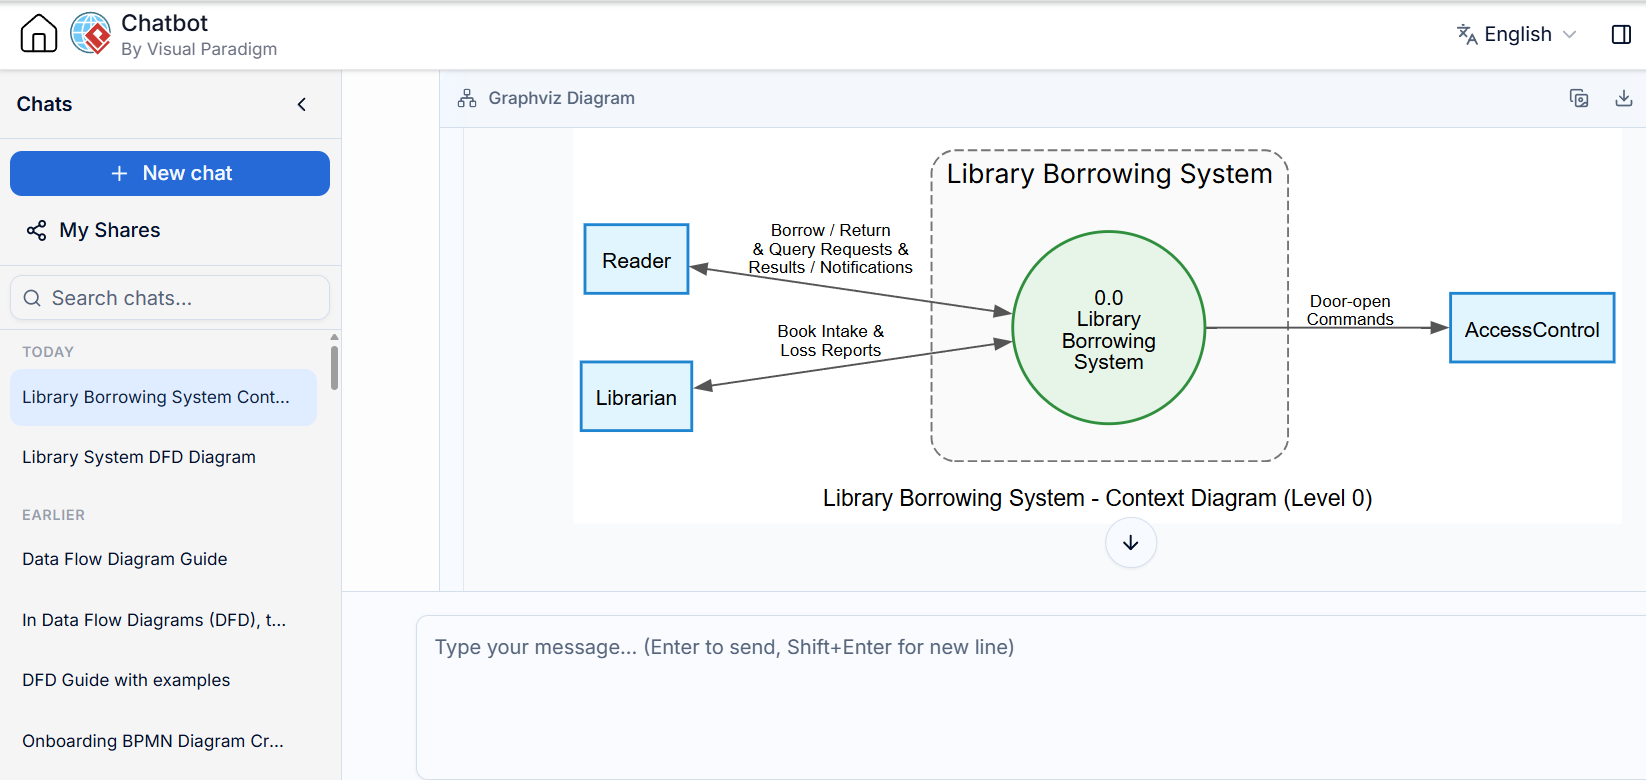
VPasCodeで開く
Graphviz Dotコードを編集することで、VPasCodeエディタでこれを修正できるようになりました。
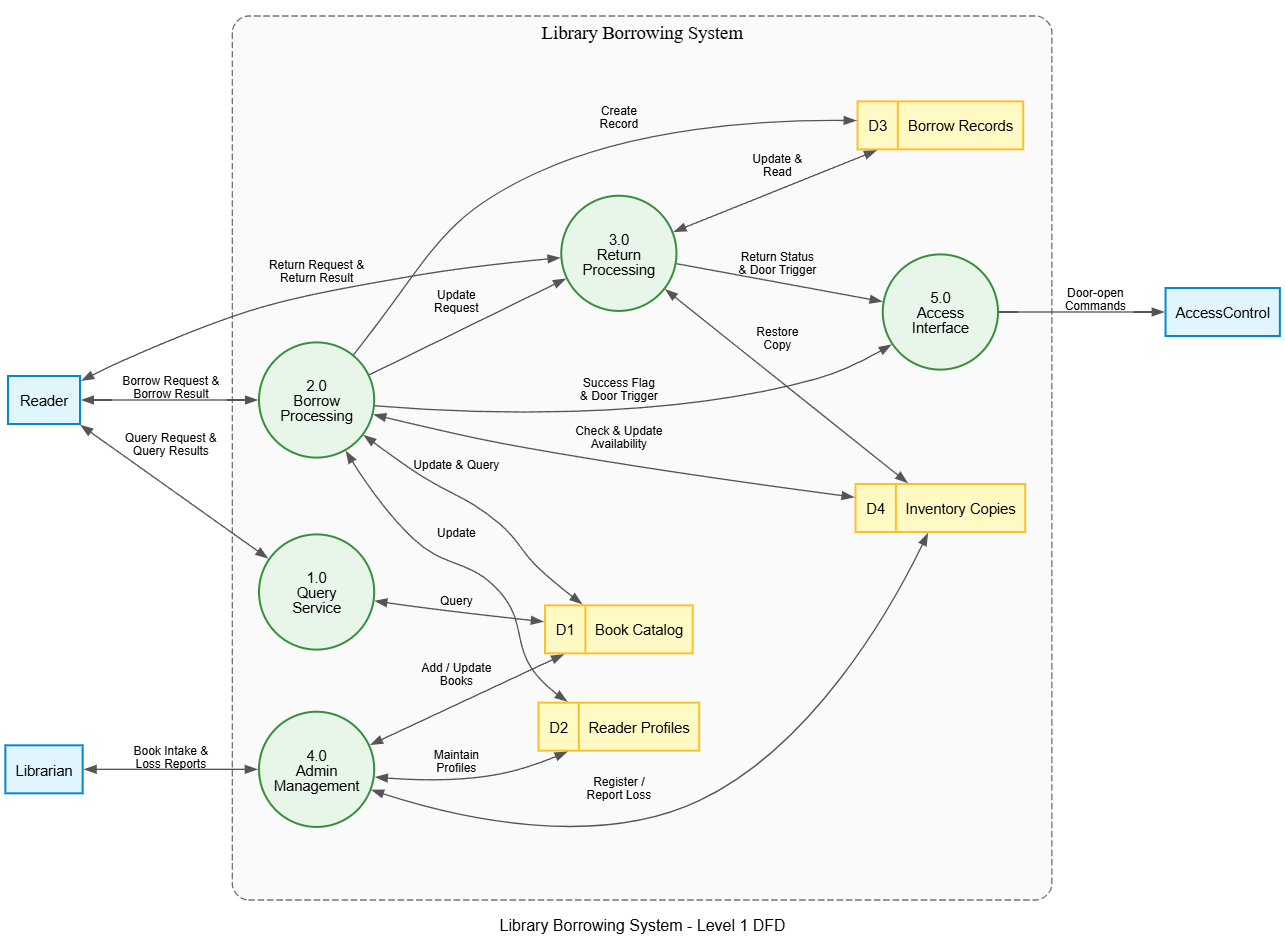
レベル0:機能分解
-
プロセス:1.0 照会サービス、2.0 貸出処理、3.0 返却処理、4.0 管理管理、5.0 アクセスインターフェース
-
データストア:D1 書籍カタログ、D2 読者プロファイル、D3 貸出記録、D4 在庫コピー
-
整合性確認:読者からの「貸出リクエスト」はプロセス2.0にマッピングされます。「ドア開放コマンド」はアクセス制御に対してプロセス5.0からマッピングされます。すべてのコンテキストレベルのフローが考慮されています。
レベル1:「2.0 貸出処理」の詳細化
-
2.1 リクエストの検証:D2を読み取り、有効なリクエストまたは失敗結果を出力します。
-
2.2 可用性の確認:D4を読み取り、利用可能なコピー情報または利用不可の結果を出力します。
-
2.3 トランザクションの実行:D3(新規レコード)に書き込み、D4(コピー状態)を更新し、D2(貸出数)を更新します。
-
2.4 応答の生成:読者に「貸出結果」を、プロセス5.0に「成功シグナル」を生成します。
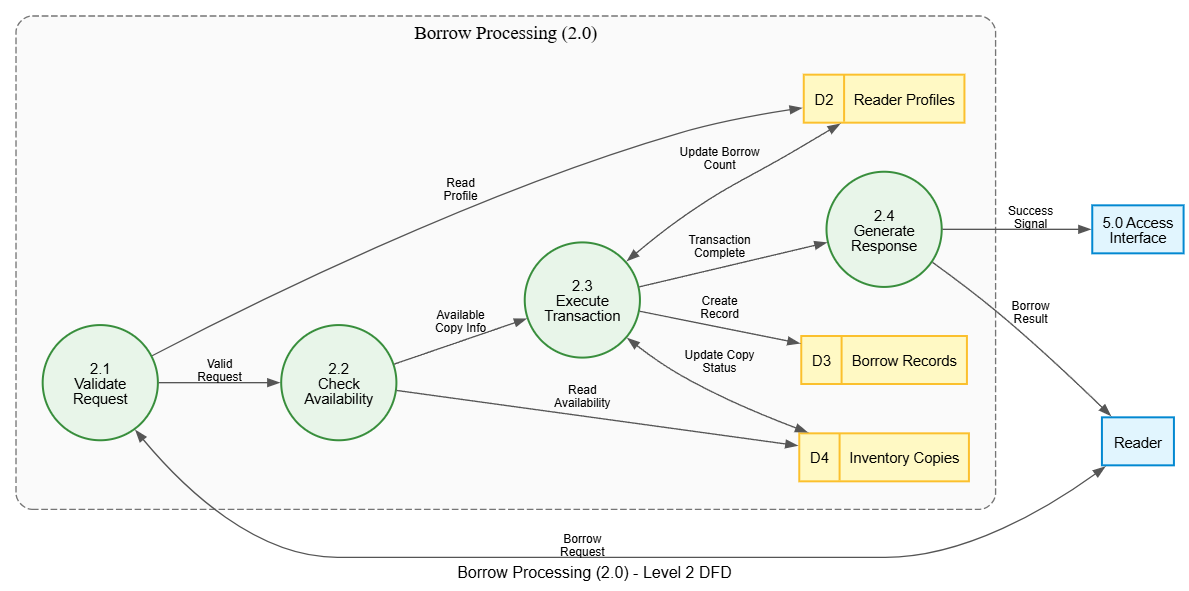
この階層化アプローチは、曖昧な「書籍の貸出」という要件を、コードを1行も書かれる前に、参照される正確なデータテーブル、適用される検証ルール、トランザクション境界を示す明確な仕様へと変換します。
4. 高度な技術と品質保証
整合性チェックリスト
各レイヤーの完了後、以下の項目に対して検証を行ってください:
-
親と子のバランス: すべての外部フローが正確に保持されていること。
-
データの保存: データの消滅(ブラックホール)、創発(奇跡)、または不明瞭な流入・流出(グレーホール)がないこと。
-
ストレージの使用: すべてのデータストアは、読み取りと書き込みの両方の接続を持つこと(または、初期化/消費の根拠が文書化されていること)。
-
命名の整合性: 同一のデータフローは、すべての図において同一の名前を使用すること。正式なデータ辞書を維持すること。
-
深さの均一性: 非対称な分解は許容されます。すべての分岐が同じ深さに達するまでではなく、明確性が得られた時点で停止すること。
制御ロジックの扱い
DFDはデータをモデル化するものであり、制御をモデル化するものではありません。条件付きロジックを表すには:
-
意思決定をプロセス内にカプセル化してください。1つのプロセスからの複数の出力フローは、異なる結果を表します(例:「検証済みリクエスト」対「拒否通知」)。
-
データフローに「はい/いいえ」というラベルを絶対に使用しないでください。説明的な名詞を使用してください:「承認済み注文」対「拒否済み注文」。
-
並行出力は有効であり、並列的なデータ生成を表します。
ツールとベストプラクティス
-
推奨ツール: Visual Paradigm Online(無料、共同編集可能、豊富なシンボルライブラリ);PlantUML/vpAsCode(バージョン管理対応、エンジニアリングチーム向けのテキストベースの図作成)。
-
ワークフロー: 常に最初に紙またはホワイトボードでスケッチし、ロジックを検証してからデジタル描画を行ってください。
-
単純性のテスト: 図が混雑していると感じたら、さらに分解してください。7±2の法則を尊重してください。
-
凡例: 見知らぬ読者のために、すべての図に記号の凡例を含めてください。
-
データ辞書: 各データフローとストレージの構造を定義する別文書を維持してください。これにより曖昧さが排除され、データベース設計に直接反映されます。
-
補完モデル: DFDはデータ変換には優れていますが、時間的順序や状態管理には適していません。完全なシステム仕様のためには、シーケンス図、状態機械、またはBPMNと組み合わせて使用してください。
結論
階層型データフロー図は単なる記法以上のものです—それは思考の規律。各層は、正確な質問をすることを強要します:このデータはどこから来るのか?何がそれを変換するのか?どこに永続するのか?何がシステムから出ていくのか?この構造化された問いかけは、高価なバグになるずっと前に、隠れた前提、論理的な隙間、明示されていない要件を明らかにします。
DFD手法の学習と適用への初期投資は、指数関数的なリターンをもたらします。要件レビューでは曖昧さを排除し、アーキテクチャの議論では共通の視覚的語彙を提供します。オンボーディングでは、自己文書化されたシステムマップとして機能します。小さく始めて、一貫して練習し、複雑なシステムが求める明確さを層が明らかにするのを待ちましょう。「ごちゃごちゃの混乱」から「精密な設計図」への移行は、最初のコンテキスト図から始まります。