

引言
每位系统分析师和软件设计师都深知这种痛苦:将模糊、零散的客户需求转化为清晰、可执行的技术规范。你可能会绘制无数张流程图和撰写数页文档,但开发人员却对功能的起止点或数据与特定模块的关系感到困惑。这种沟通鸿沟是项目延期和返工的主要原因。
解决方案并非更多的文档,而是更好的结构化可视化。分层数据流图(DFD) 是剖析复杂系统的终极“手术刀”。与通用流程图不同,DFD专注于数据转换和流动,采用自上而下的分解策略,有效管理认知负荷。
本综合指南超越理论,提供经过实战检验的框架,用于掌握分层DFD。无论您是产品经理、系统分析师还是开发人员,本指南都将为您提供方法论,将混乱的需求转化为精确、可操作的蓝图。
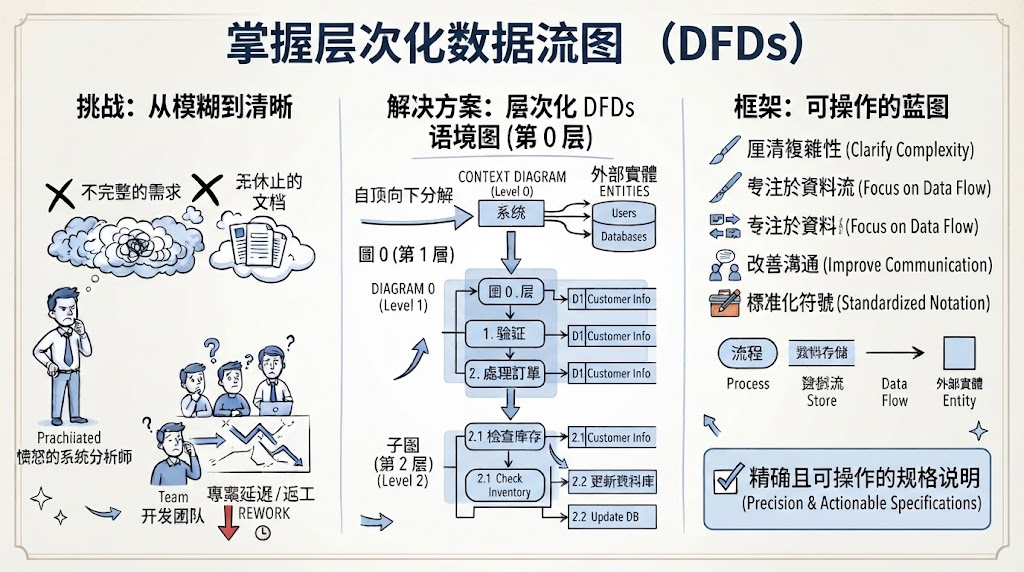
关于视觉资源的说明:由于本基于文本的指南重构了原始内容,请参阅原始资料以获取第3节和第4节中引用的具体图表。以下文本描述旨在与这些视觉示例完美对应。
关键概念一览
在深入绘图过程之前,请先内化这些基础概念:
| 概念 | 定义 | 重要性 |
|---|---|---|
| 分解 | 将复杂系统分解为可管理、嵌套的层级。 | 防止认知过载;支持团队并行分析。 |
| 抽象 | 在高层接口背后隐藏底层实现细节。 | 使利益相关者能够专注于相关层级的细节。 |
| 平衡原则 | 确保父图与子图之间的输入/输出数据流完全匹配。 | 保证逻辑一致性,防止“数据泄漏”。 |
| 7±2法则 | 将每张图中的处理过程数量限制在 5 到 9 个元素之间。 | 与人类的短期记忆容量相一致,以提升可读性。 |
| 功能内聚 | 将操作同一核心数据对象的子过程进行分组。 | 创建可维护且松耦合的系统模块。 |
1. 分层哲学:为何不采用一张巨型地图?
试图在单张图中描绘整个企业系统是一种工程反模式。分层数据流图其存在源于两个基本约束:人类认知能力和软件可维护性。
认知极限
认知心理学的研究表明,人类一次只能有效处理 5 到 9 个信息块。包含数百个节点的单体图违反了这一限制,使其无法用于沟通。分层通过一次呈现一个连贯的抽象层级来尊重这一边界。
工程优势
-
复杂度控制:读者更容易消化简洁、聚焦的图表,而非令人不知所措的庞大地图。
-
并行工作流:不同团队可以负责不同的层级或模块,而无需频繁发生合并冲突。
-
变更隔离:修改通常仅影响特定层级及其直接子层级,使影响分析具有可预测性。
-
敏捷对齐:自上而下的细化反映了迭代开发,使高层设计能够稳定,同时细节不断演进。
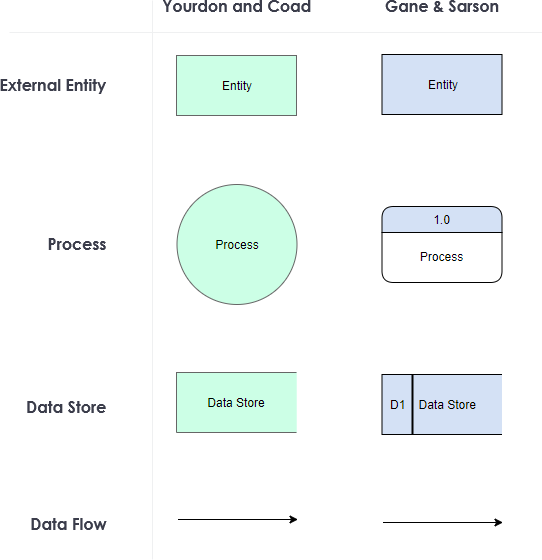
数据流图符号的四大支柱
将这些视为你的乐高积木。误解它们将必然导致模型存在缺陷。
-
外部实体(正方形/矩形):数据的来源或目的地系统边界之外(例如:客户、支付网关)。规则:你无法改变其行为;只能定义与它们的接口。
-
处理过程(圆角矩形/圆形):数据的转换。每个处理过程必须同时具有输入和输出。规则: 处理过程通过计算、验证、过滤或聚合来改变数据状态。
-
数据存储(开口矩形/平行线): 静态存储库(数据库、文件、缓存)。规则: 表示数据随时间的持久性。处理过程从存储中读取数据并向存储写入数据。
-
数据流(带箭头的线): 数据包在实体、处理过程和存储之间的移动。规则: 必须用名词短语标注(例如“订单详情”,而非“提交订单”)。数据流代表数据,而绝非物理对象或纯粹的控制信号。
2. 逐步绘图方法论
创建分层数据流图(DFD)是一个严谨的、顺序执行的过程。每一步都有特定的验证标准。
步骤 1:上下文图(顶层)
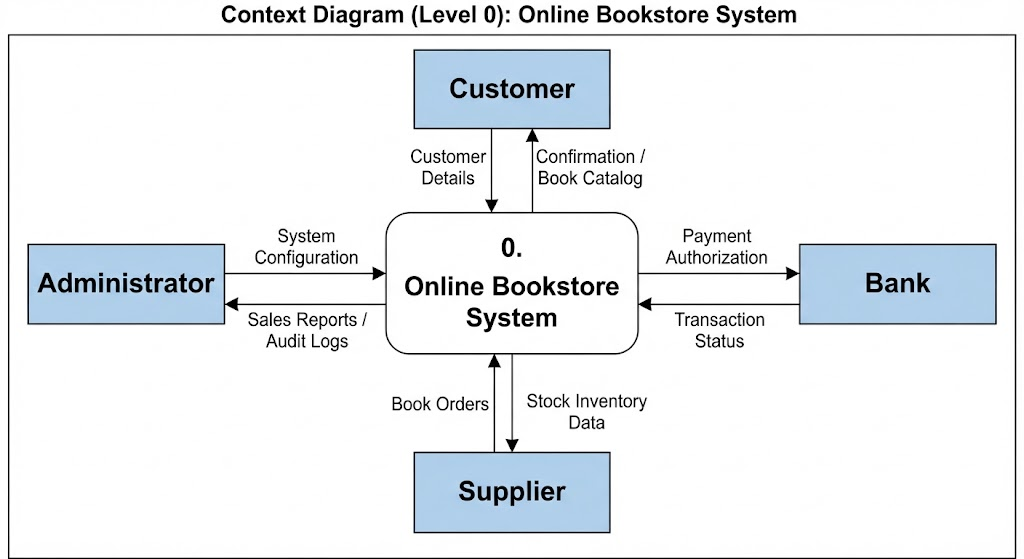
目标: 定义系统边界和外部接口。这是您系统的“宪法”。
-
绘制一个代表整个系统的中心处理过程。
-
识别所有与系统交互的外部实体。
-
用带标签的数据流将实体连接到中心处理过程。
-
关键约束: 外部实体之间不得存在直接的数据流。所有交互必须经过系统。此层级不出现数据存储。
[插入原始图片:上下文图示例——在线书店系统]
实用提示: 数据流请使用名词短语。“支付信息”是正确的;“处理支付”是错误的。确保所有后续层级中外部实体的名称保持一致。
步骤 2:0 层图(系统概览)
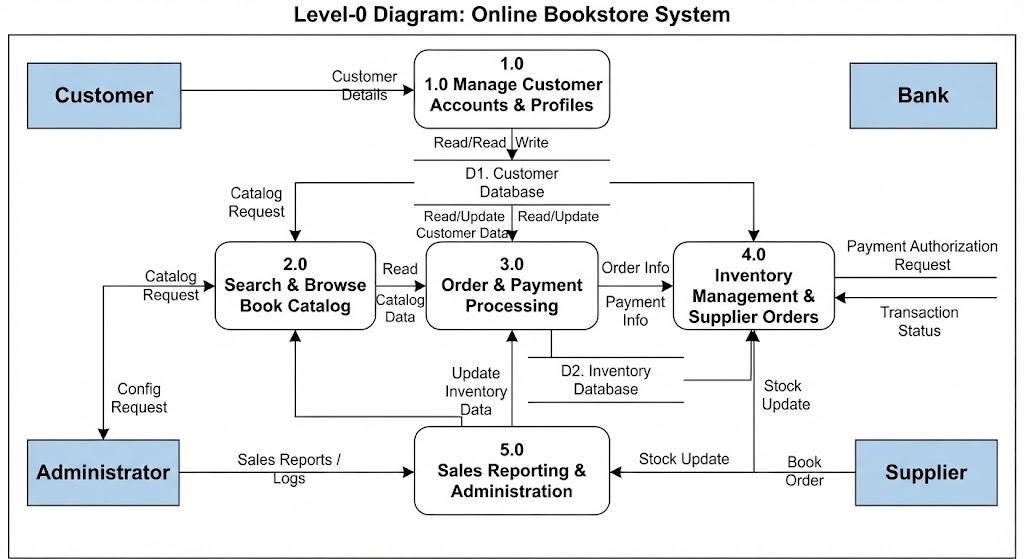
目标: 将中心处理过程分解为主要的功能子系统。
-
将中心处理过程分解为 3 至 7 个主要子过程,以代表核心业务能力。
-
保留上下文图中的所有外部实体。
-
平衡检查:上下文图中的每个输入/输出流必须与第 0 层中的子过程精确对应。数据不得凭空出现或消失。
-
引入服务于多个过程的内部数据存储。
[插入原始图片:第 0 层图示例——在线书店系统]
验证:逐行进行审计。如果上下文图显示“客户 → 系统:订单信息”,则第 0 层必须显示“客户 → 过程 3.0:订单信息”。缺失或多余的流表明分解错误。
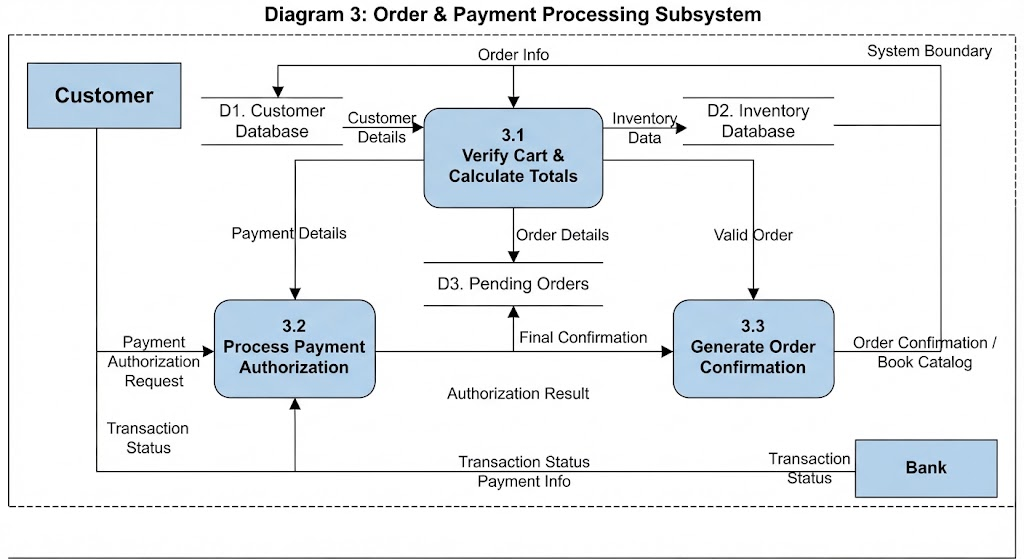
步骤 3:低层图(渐进细化)
目标:将复杂的第 0 层过程分解,直到每个过程达到“功能原语”状态——简单到可以用伪代码或决策表描述。
-
子图编号应与其父过程对应(例如,过程 3.0 扩展为图 3)。
-
精确继承所有父过程的输入/输出。
-
根据需要添加内部数据流和本地数据存储。
-
当一个过程可以作为单个函数/方法实现时,停止分解。
需避免的常见反模式
| 反模式 | 描述 | 修正 |
|---|---|---|
| 黑洞 | 过程有输入但无输出。 | 识别缺失的输出:错误消息、日志条目或状态更新。 |
| 奇迹 | 过程有输出但无输入。 | 追溯数据来源:缺失的输入流或未被读取的数据存储。 |
| 灰洞 | 输入不足以产生所述输出。 | 添加缺失的输入数据流或数据存储读取。 |
| 存储到存储流 | 两个数据存储之间的直接箭头。 | 在存储之间插入一个过程;数据移动需要转换。 |
| 实体到实体流 | 外部实体之间的直接箭头。 | 从数据流图中移除;此操作发生在系统范围之外。 |
3. 综合案例研究:图书借阅系统
为了综合所有概念,我们将通过一个完整的图书馆系统示例进行讲解。(请参阅原始图像,以查看以下各层的可视化表示。)
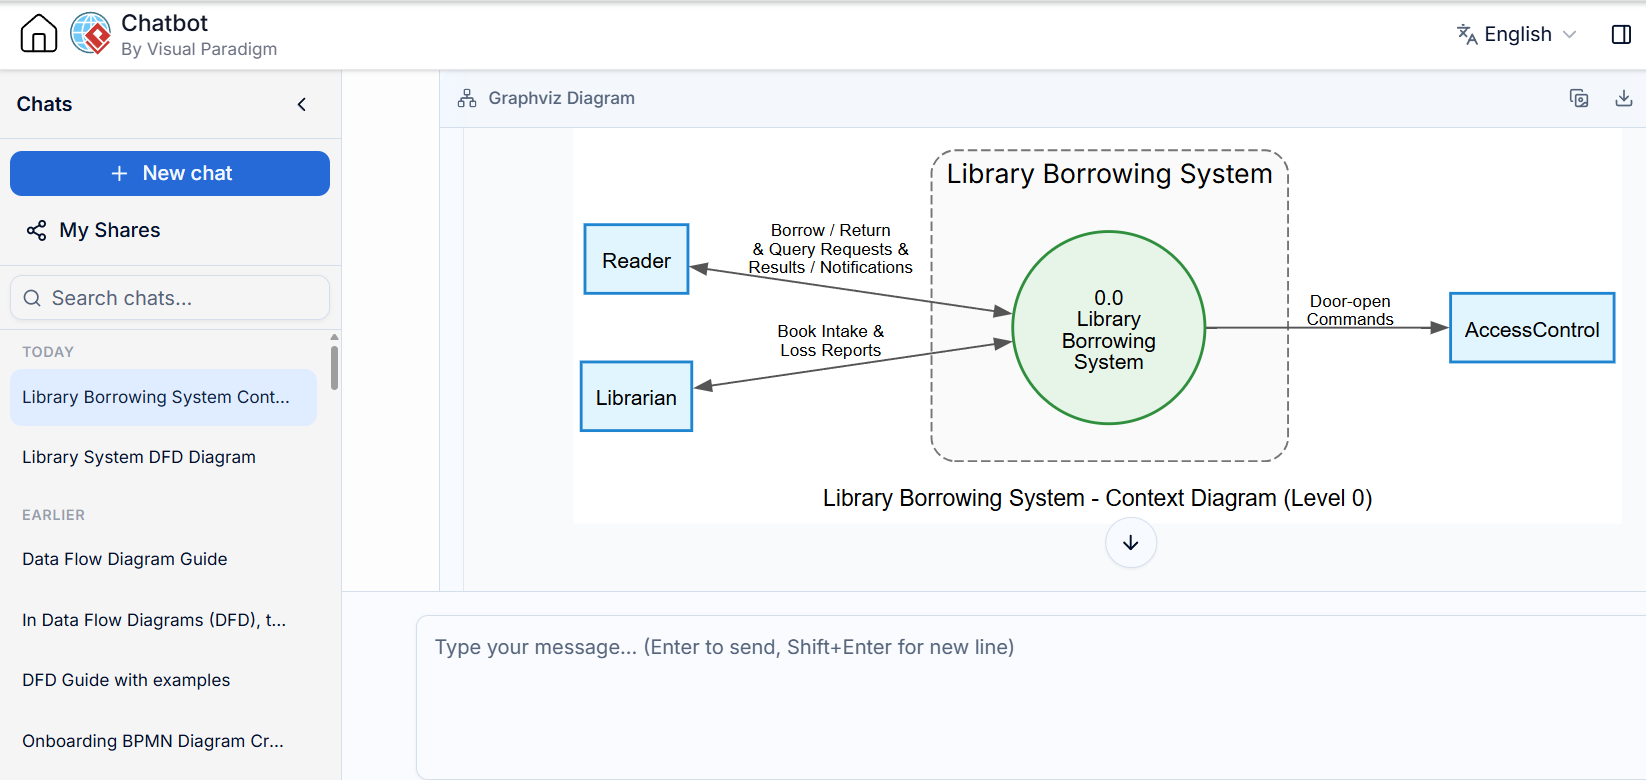
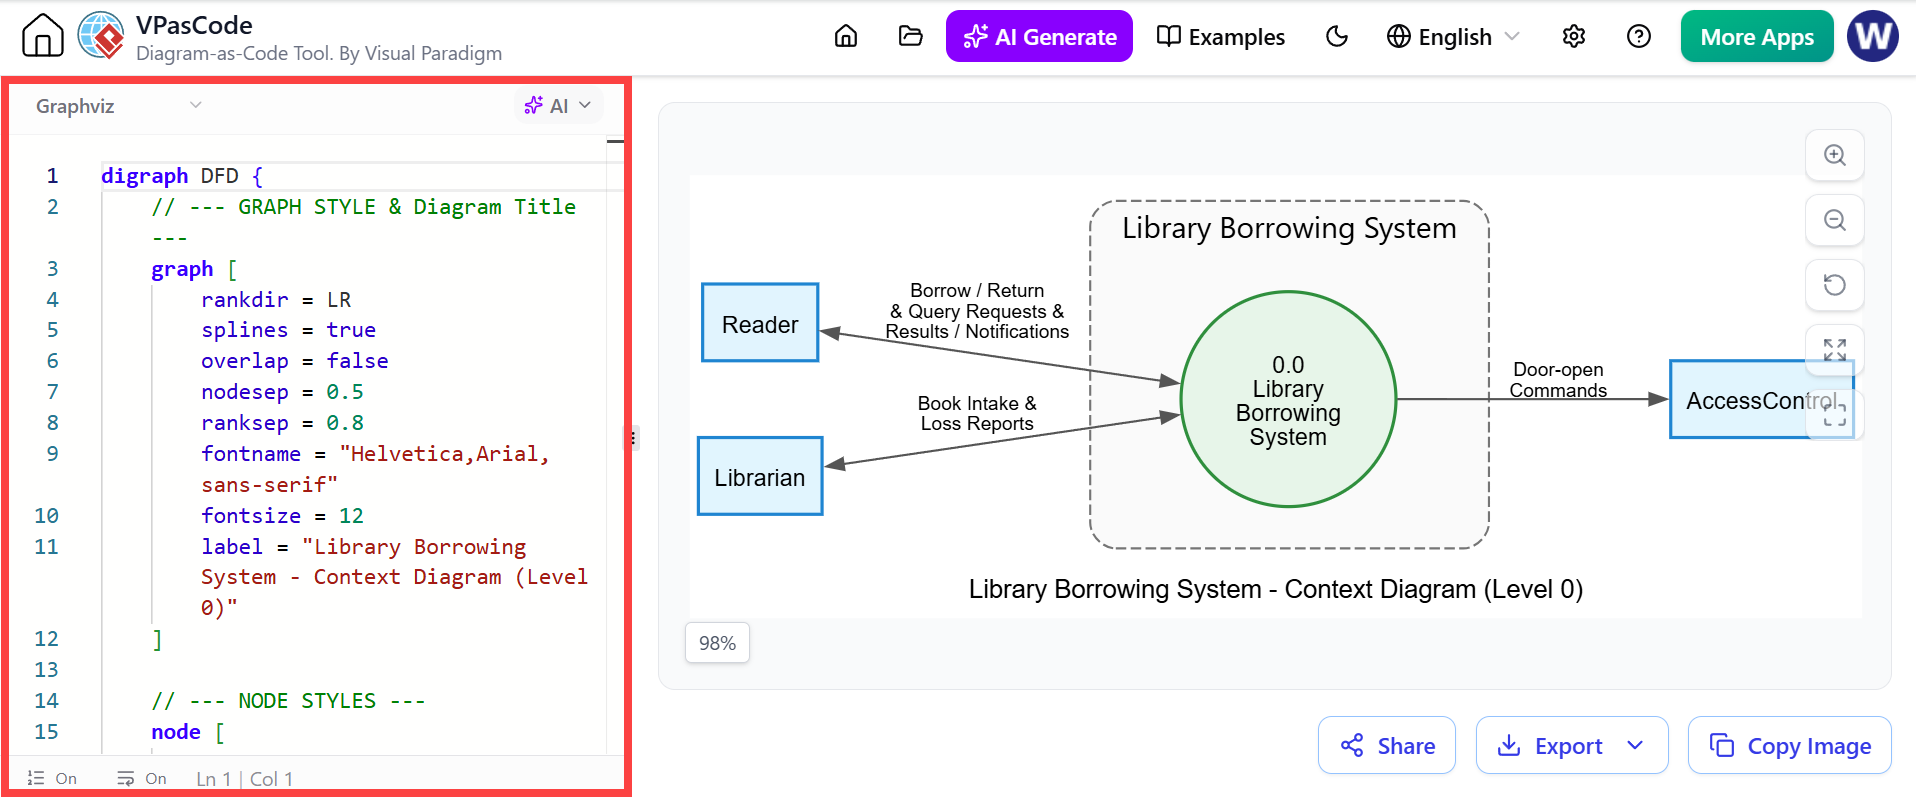
上下文图:边界定义
系统:图书借阅系统
-
外部实体:读者、图书管理员、访问控制系统(外部硬件)
-
关键流程:读者提交借阅/归还/查询请求;系统返回结果和通知;图书管理员提供图书入库和丢失报告;系统在成功借阅时向访问控制系统发送开门指令。
在 VPasCode 中打开
您现在可以通过编辑 Graphviz Dot 代码在 VPasCode 编辑器中对其进行修改。
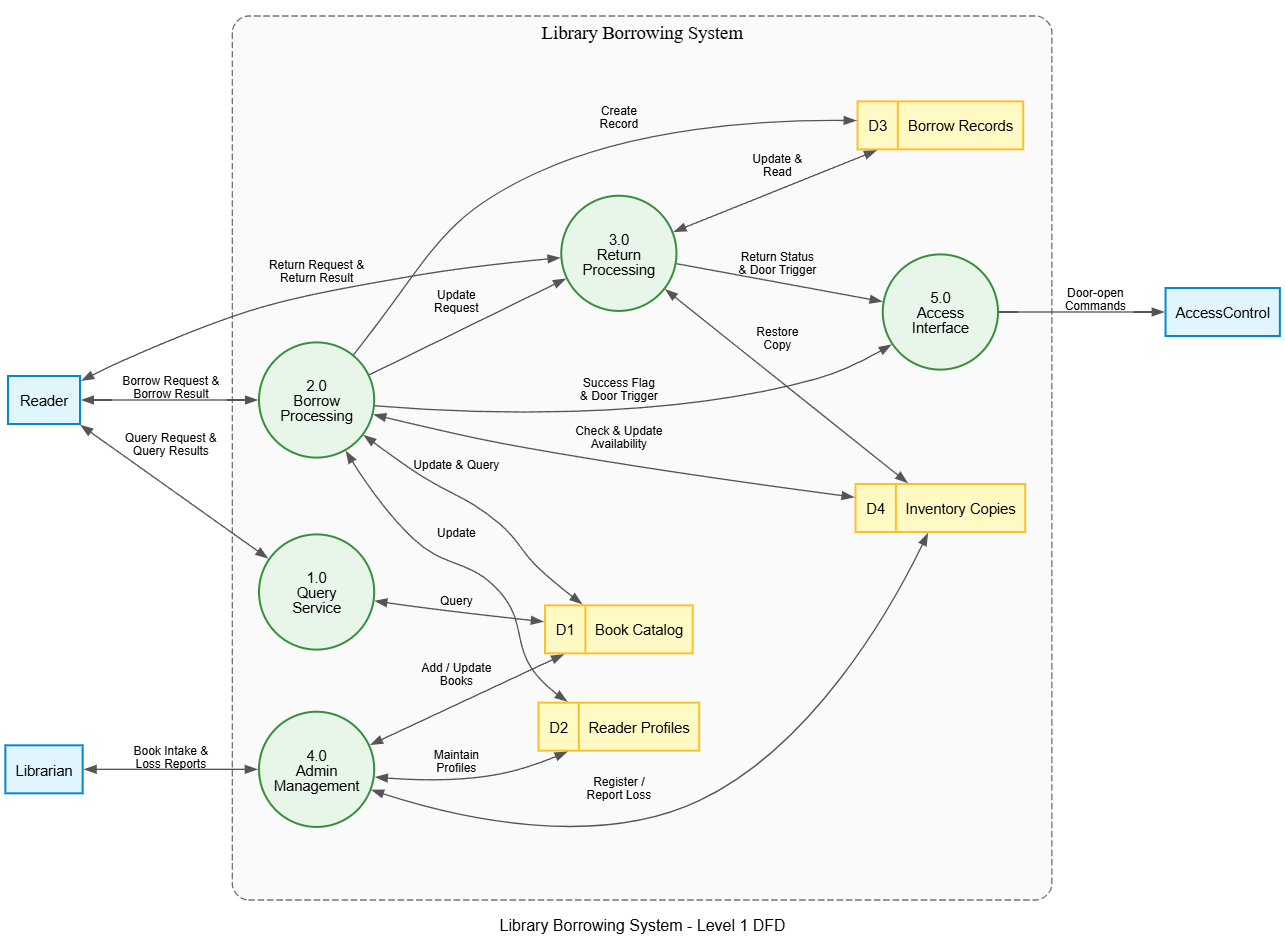
0 级:功能分解
-
处理过程:1.0 查询服务,2.0 借阅处理,3.0 归还处理,4.0 管理,5.0 访问接口
-
数据存储:D1 图书目录,D2 读者档案,D3 借阅记录,D4 库存副本
-
平衡验证:来自读者的“借阅请求”映射到过程 2.0;发送给访问控制系统的“开门指令”源自过程 5.0;所有上下文级别的流程均已涵盖。
1 级:细化“2.0 借阅处理”
-
2.1 验证请求:读取 D2;输出有效请求或失败结果。
-
2.2 检查可用性:读取 D4;输出可用副本信息或不可用结果。
-
2.3 执行交易:写入 D3(新记录),更新 D4(副本状态),更新 D2(借阅次数)。
-
2.4 生成响应:向读者生成“借阅结果”,并向过程 5.0 发送“成功信号”。
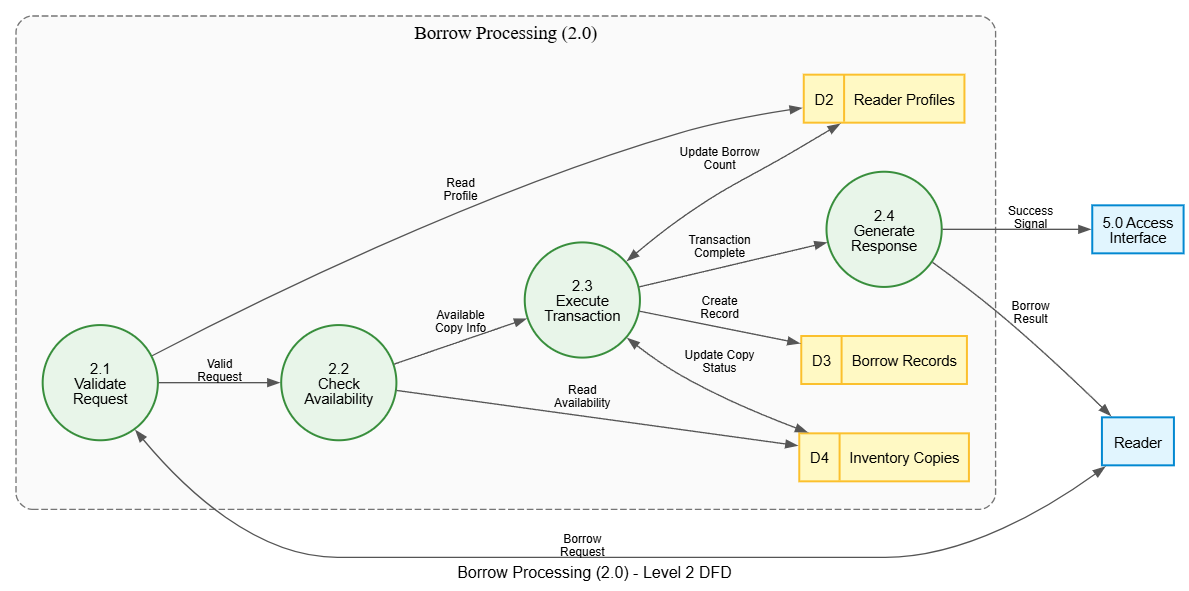
这种分层方法将一个模糊的“借阅图书”需求转化为精确的规格说明,明确显示所涉及的确切数据表、应用的验证规则以及事务边界——所有这些都在编写任何一行代码之前完成。
4. 高级技术与质量保证
一致性检查清单
完成每一层后,请对照以下项进行验证:
-
父子平衡:所有外部流必须完全保留。
-
数据守恒:不存在黑洞、奇迹或灰洞。
-
存储使用情况:每个数据存储都必须具备读和写连接(或已文档化的初始化/消耗理由)。
-
命名一致性:相同的数据流在所有图表中必须使用相同的名称。请维护正式的数据字典。
-
深度一致性:允许非对称分解;一旦达到清晰性即可停止,无需所有分支达到相同深度。
处理控制逻辑
数据流图(DFD)建模的是数据,而非控制。为表示条件逻辑:
-
将决策封装在过程内部。来自同一过程的多个输出流代表不同的结果(例如,“已验证请求”与“拒绝通知”)。
-
切勿用“是/否”标记数据流。请使用描述性名词:“已批准订单”与“已拒绝订单”。
-
并发输出是有效的,代表并行数据生成。
工具与最佳实践
-
推荐工具:Visual Paradigm Online(免费、支持协作、符号库丰富);PlantUML/vpAsCode(支持版本控制,以文本作为图表,适用于工程团队)。
-
工作流程:始终先在纸面或白板上草绘,以在数字化绘制前验证逻辑。
-
简洁性测试:如果图表感觉拥挤,请进一步分解。请遵循 7±2 法则。
-
图例: 为不熟悉内容的读者,在每个图表中包含符号图例。
-
数据字典: 维护一份独立文档,定义每个数据流和存储的结构。这消除了歧义,并直接用于数据库设计。
-
互补模型: 数据流图(DFD)擅长描述数据转换,但不擅长时间序列或状态管理。应将其与序列图、状态机或 BPMN 配合使用,以实现完整的系统规格说明。
结论
分层数据流图不仅仅是一种符号表示法——它们是一种思维纪律。每一层都迫使你提出精确的问题:数据来自哪里?什么对其进行了转换?它存储在哪里?什么离开了系统?这种结构化的质询能在问题演变为昂贵的缺陷之前,就揭示出隐藏的假设、逻辑漏洞和未声明的需求。
学习和应用 DFD 方法论的初期投入将带来指数级的回报。在需求评审中,它们消除了歧义;在架构讨论中,它们提供了共享的视觉词汇;在入职培训中,它们充当自文档化的系统地图。从小处着手,持续练习,让各层级揭示复杂系统所需的清晰度。从“混乱一团”到“精确蓝图”的转变,始于你的第一张上下文图。