


Введение
Каждый системный аналитик и разработчик программного обеспечения знает эту боль: перевод размытых, фрагментированных требований заказчика в четкую, исполняемую техническую спецификацию. Вы можете создавать бесконечные блок-схемы и страницы документации, но разработчики в ответ выражают недоумение относительно того, где начинаются и заканчиваются функции или как данные связаны с конкретными модулями. Этот разрыв в коммуникации является основной причиной задержек проектов и переделок.
Решение заключается не в большем объеме документации, а в более качественнойструктурированнойвизуализации.Иерархические диаграммы потоков данных (ДПД) служат бесспорным «скальпелем» для анализа сложных систем. В отличие от общих блок-схем,ДПДстрого фокусируются на преобразовании и перемещении данных, используя стратегию декомпозиции сверху вниз, которая эффективно управляет когнитивной нагрузкой.
Это всеобъемлющее руководство выходит за рамки теории, предоставляя проверенную на практике рамочную основу дляосвоения иерархических ДПДс. Независимо от того, являетесь ли вы менеджером продукта, системным аналитиком или разработчиком, это руководство вооружит вас методологией для превращения хаотичных требований в точные, действенные планы.
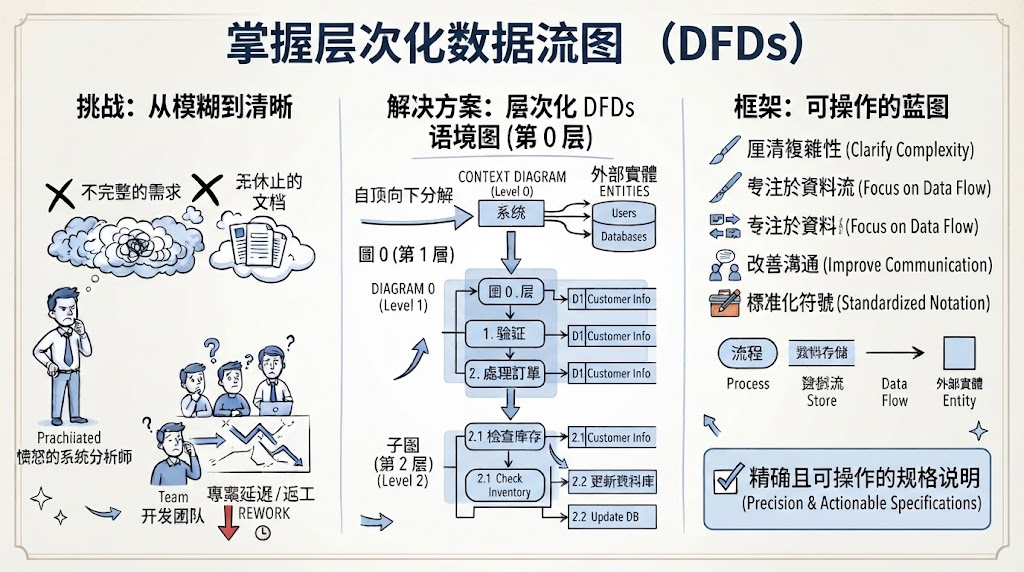
Примечание о визуальных материалах:Поскольку это текстовое руководство воссоздает исходный контент, пожалуйста, обращайтесь к вашему первоначальному источнику для получения конкретных диаграмм, упомянутых в разделах 3 и 4. Приведенные ниже текстовые описания разработаны так, чтобы идеально соответствовать этим визуальным примерам.
Ключевые концепции вкратце
Прежде чем приступить к процессу построения диаграмм, усвойте эти фундаментальные концепции:
| Концепция | Определение | Почему это важно |
|---|---|---|
| Декомпозиция | Разбиение сложной системы на управляемые, вложенные уровни. | Предотвращает когнитивную перегрузку; позволяет проводить параллельный анализ командой. |
| Абстракция | Скрытие деталей реализации нижнего уровня за интерфейсами более высокого уровня. | Позволяет заинтересованным сторонам сосредоточиться на соответствующих уровнях детализации. |
| Принцип баланса | Обеспечение точного совпадения потоков входных/выходных данных между родительскими и дочерними диаграммами. | Гарантирует логическую согласованность и предотвращает «утечку данных». |
| Правило 7±2 | Ограничение количества процессов на диаграмме от 5 до 9 элементов. | Соответствует ёмкости кратковременной памяти человека для обеспечения читаемости. |
| Функциональная связность | Группировка подпроцессов, работающих с одним и тем же основным объектом данных. | Создаёт поддерживаемые модули системы с слабой связностью. |
1. Философия многоуровневости: почему не одна гигантская карта?
Попытка отобразить всю корпоративную систему на одной диаграмме является антипаттерном в инженерии.Иерархические диаграммы потоков данных (DFD)существуют из-за двух фундаментальных ограничений: человеческое познание и поддерживаемость программного обеспечения.
Когнитивный предел
Исследования в области когнитивной психологии показывают, что люди могут эффективно обрабатывать только от 5 до 9 информационных блоков одновременно. Монолитная диаграмма со сотнями узлов нарушает этот предел, делая её бесполезной для коммуникации. Многоуровневость уважает эту границу, представляя один согласованный уровень абстракции за раз.
Инженерные преимущества
-
Контроль сложности:Читатели усваивают простые, сфокусированные диаграммы, а не подавляющие карты.
-
Параллельные рабочие потоки:Разные команды могут отвечать за разные уровни или модули без постоянных конфликтов при слиянии.
-
Изоляция изменений:Изменения обычно затрагивают только конкретный уровень и его непосредственные дочерние элементы, что делает анализ воздействия предсказуемым.
-
Согласованность с Agile:Уточнение сверху вниз отражает итеративную разработку, позволяя высокоуровневому дизайну стабилизироваться, в то время как детали развиваются.
Четыре столпа нотации DFD
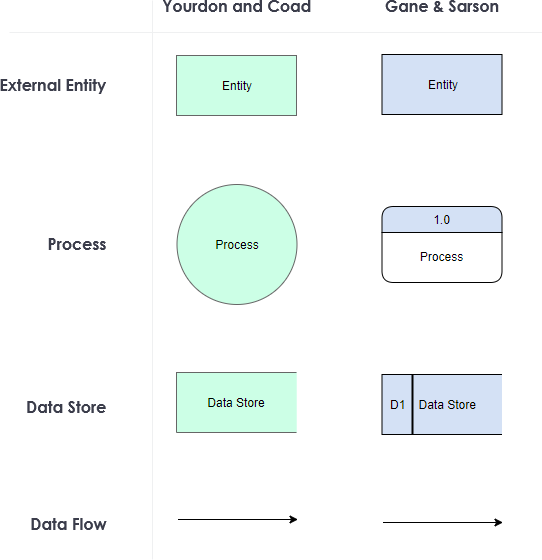
Воспринимайте их как свои LEGO-кирпичики. Непонимание их гарантирует создание дефектных моделей.
-
Внешняя сущность (квадрат/прямоугольник):Источники или получатели данныхзаграницами системы (например, Клиент, Платёжный шлюз).Правило:Вы не можете изменить их поведение; вы можете только определить интерфейсы с ними.
-
Процесс (скруглённый прямоугольник/круг):Преобразования данных. Каждый процесс должен иметь как вход, так и выход.Правило:Процессы изменяют состояние данных посредством вычислений, проверки, фильтрации или агрегации.
-
Хранилище данных (открытый прямоугольник/параллельные линии):Статические хранилища (базы данных, файлы, кэши).Правило:Представляет сохранение данных во времени. Процессы читают из хранилищ и записывают в них.
-
Поток данных (стрелочная линия):Перемещение пакетов данных между сущностями, процессами и хранилищами.Правило:Должно быть подписано существительным выражением (например, «Детали заказа», а не «Оформить заказ»). Потоки представляют данные, никогда не физические объекты или чистые управляющие сигналы.
2. Пошаговая методика построения
Создание иерархической DFD — это дисциплинированный последовательный процесс. Каждый шаг имеет конкретные критерии проверки.
Шаг 1: Диаграмма контекста (верхний уровень)
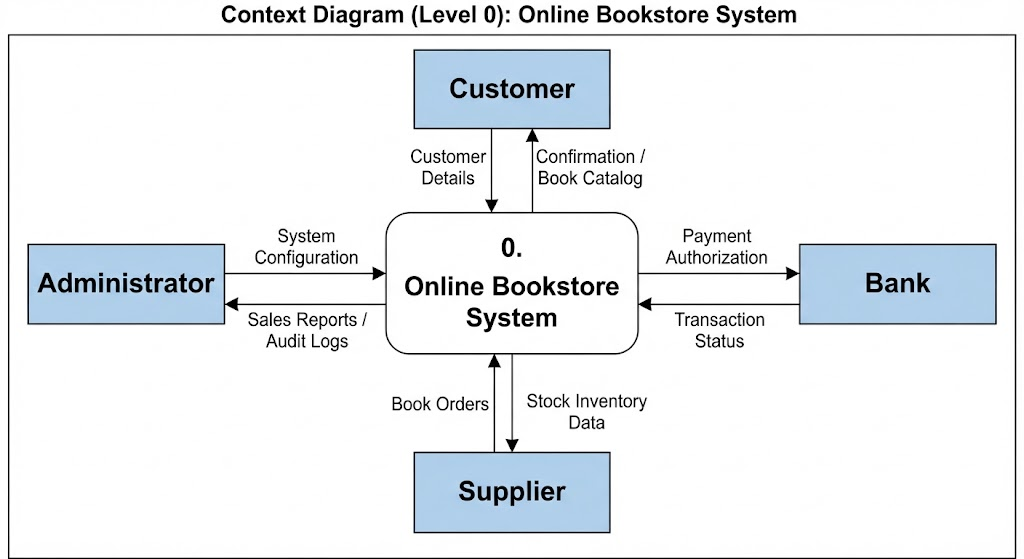
Цель:Определить границы системы и внешние интерфейсы. Это «конституция» вашей системы.
-
Нарисуйте один центральный процесс, представляющий всю систему.
-
Определите все внешние сущности, взаимодействующие с системой.
-
Соедините сущности с центральным процессом помеченными потоками данных.
-
Критическое ограничение:Нет потоков данных напрямую между внешними сущностями. Все взаимодействия должны проходить через систему. На этом уровне хранилища данных не отображаются.
[Вставить оригинальное изображение: Пример диаграммы контекста — Система интернет-магазина книг]
Практический совет:Используйте существительные выражения для потоков данных. «Информация об оплате» — правильно; «Обработать оплату» — неправильно. Убедитесь, что имена внешних сущностей остаются согласованными во всех последующих слоях.
Шаг 2: Диаграмма уровня 0 (общий обзор системы)
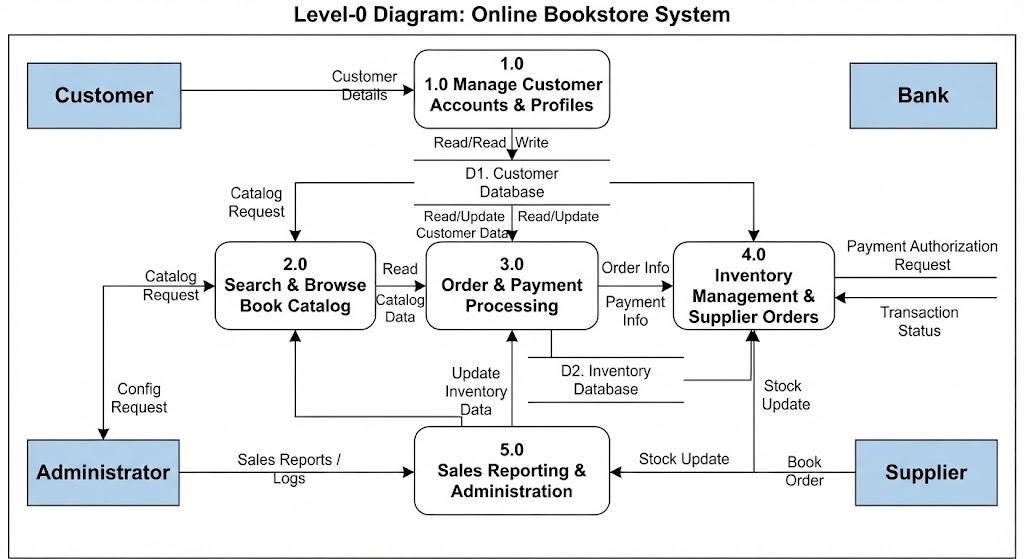
Цель:Декомпозировать центральный процесс на основные функциональные подсистемы.
-
Разбить центральный процесс на 3–7 основных подпроцессов, представляющих ключевые бизнес-возможности.
-
Сохраните все внешние сущности из диаграммы контекста.
-
Проверка баланса:Каждый поток ввода/вывода из диаграммы контекста должен точно соответствовать подпроцессу на уровне 0. Данные не могут появляться или исчезать.
-
Введите внутренние хранилища данных, обслуживающие несколько процессов.
[Вставьте оригинальное изображение: Пример диаграммы уровня 0 — Система онлайн-книжного магазина]
Валидация:Выполните посрочную проверку. Если диаграмма контекста показывает «Клиент → Система: Информация о заказе», то диаграмма уровня 0 должна показывать «Клиент → Процесс 3.0: Информация о заказе». Отсутствие или наличие лишних потоков указывает на ошибки декомпозиции.
Шаг 3: Диаграммы нижнего уровня (поэтапное уточнение)
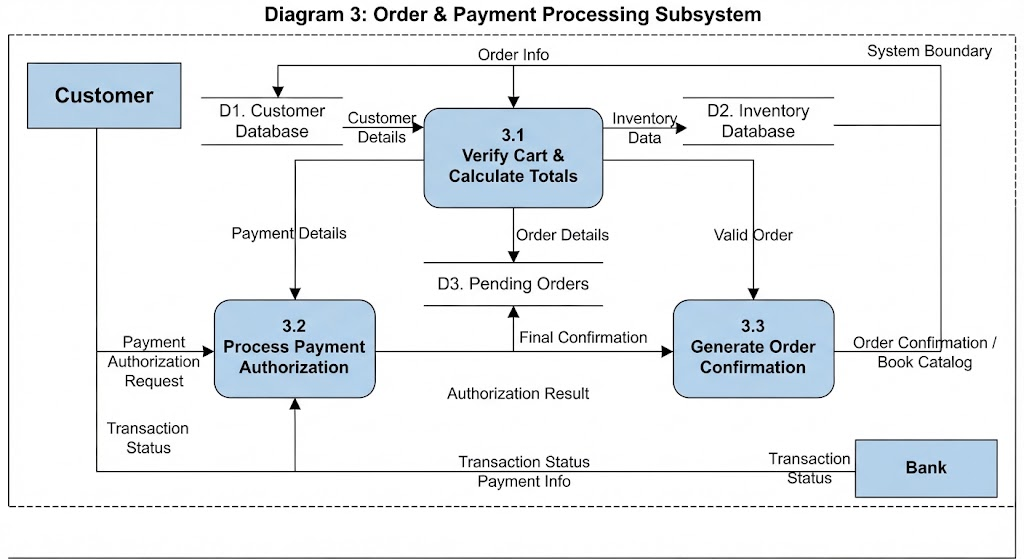
Цель:Декомпозируйте сложные процессы уровня 0 до тех пор, пока каждый из них не достигнет статуса «функционального примитива» — простого достаточно для описания в псевдокоде или таблице решений.
-
Нумеруйте дочерние диаграммы после их родительского процесса (например, процесс 3.0 раскрывается в диаграмму 3).
-
Точно наследуйте все входы/выходы родительского процесса.
-
Добавьте внутренние потоки данных и локальные хранилища данных по мере необходимости.
-
Остановите декомпозицию, когда процесс может быть реализован как одна функция/метод.
Распространённые антипаттерны, которых следует избегать
| Антипаттерн | Описание | Исправление |
|---|---|---|
| Чёрная дыра | Процесс имеет входы, но не имеет выходов. | Выявите отсутствующий выход: сообщение об ошибке, запись в журнале или обновление статуса. |
| Чудо | Процесс имеет выходы, но не имеет входов. | Отследите происхождение данных: отсутствующий входной поток или нечитаемое хранилище данных. |
| Серая дыра | Входов недостаточно для получения заявленных выходов. | Добавьте недостающие входные потоки данных или чтения из хранилищ данных. |
| Поток «хранилище-в-хранилище» | Прямая стрелка между двумя хранилищами данных. | Вставьте процесс между хранилищами; перемещение данных требует преобразования. |
| Поток «сущность-в-сущность» | Прямая стрелка между внешними сущностями. | Удалить из DFD; это происходит за пределами области системы. |
3. Интегрированный кейс-стади: Система выдачи книг в библиотеке
Чтобы синтезировать все концепции, мы пройдём через полный пример системы библиотеки.(См. оригинальные изображения для визуального представления каждого описанного ниже уровня.)
Контекстная диаграмма: Определение границ
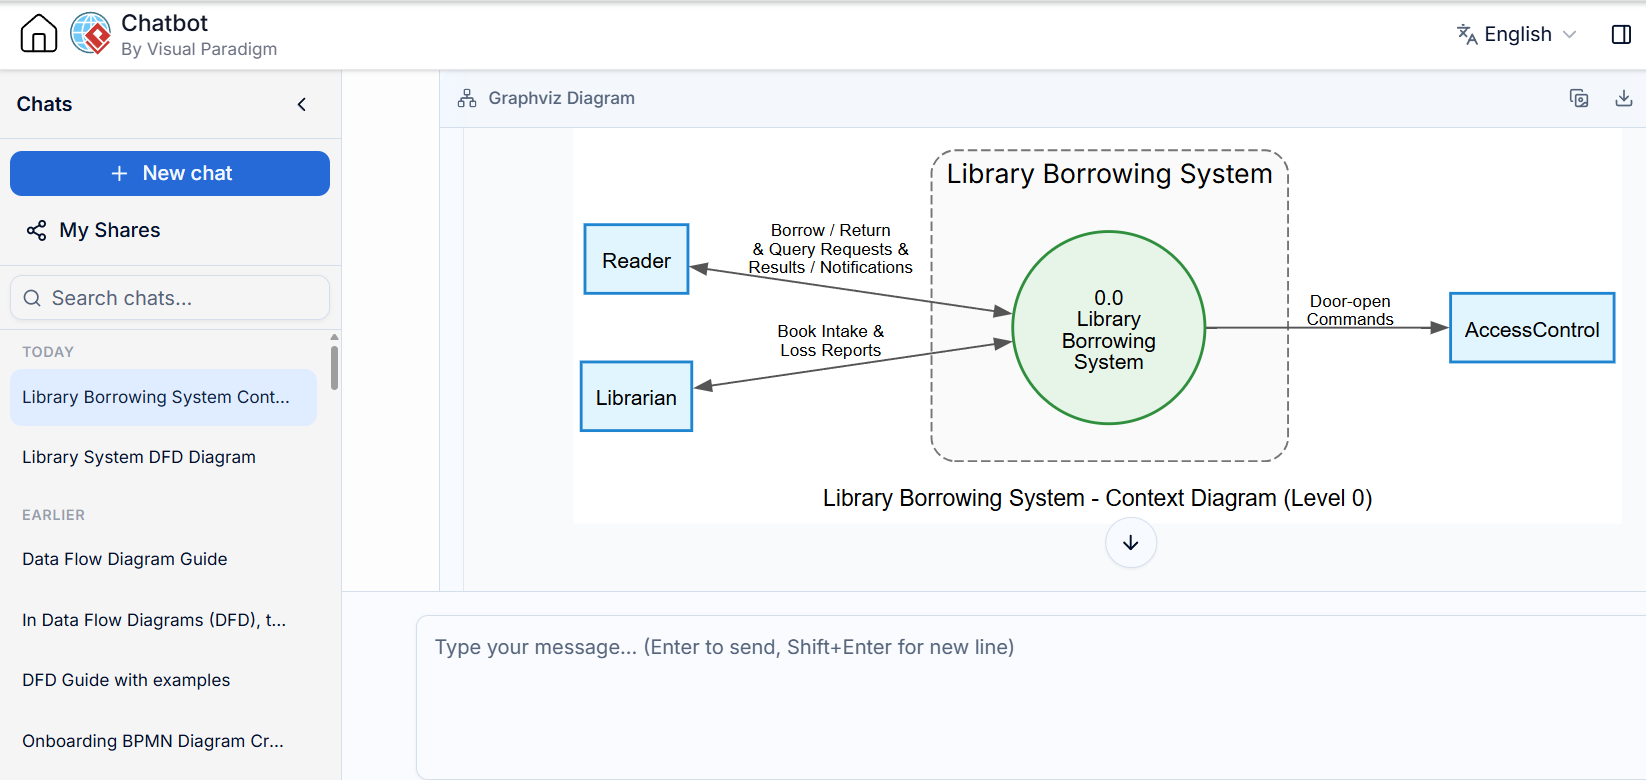
Система: Система выдачи книг в библиотеке
-
Внешние сущности: Читатель, Библиотекарь, Система контроля доступа (внешнее оборудование)
-
Ключевые потоки: Читатель подаёт запросы на выдачу/возврат/поиск; Система возвращает результаты и уведомления; Библиотекарь предоставляет отчёты о приёме книг и их утрате; Система отправляет команды на открытие двери в Систему контроля доступа при успешной выдаче.
Открыть в VPasCode
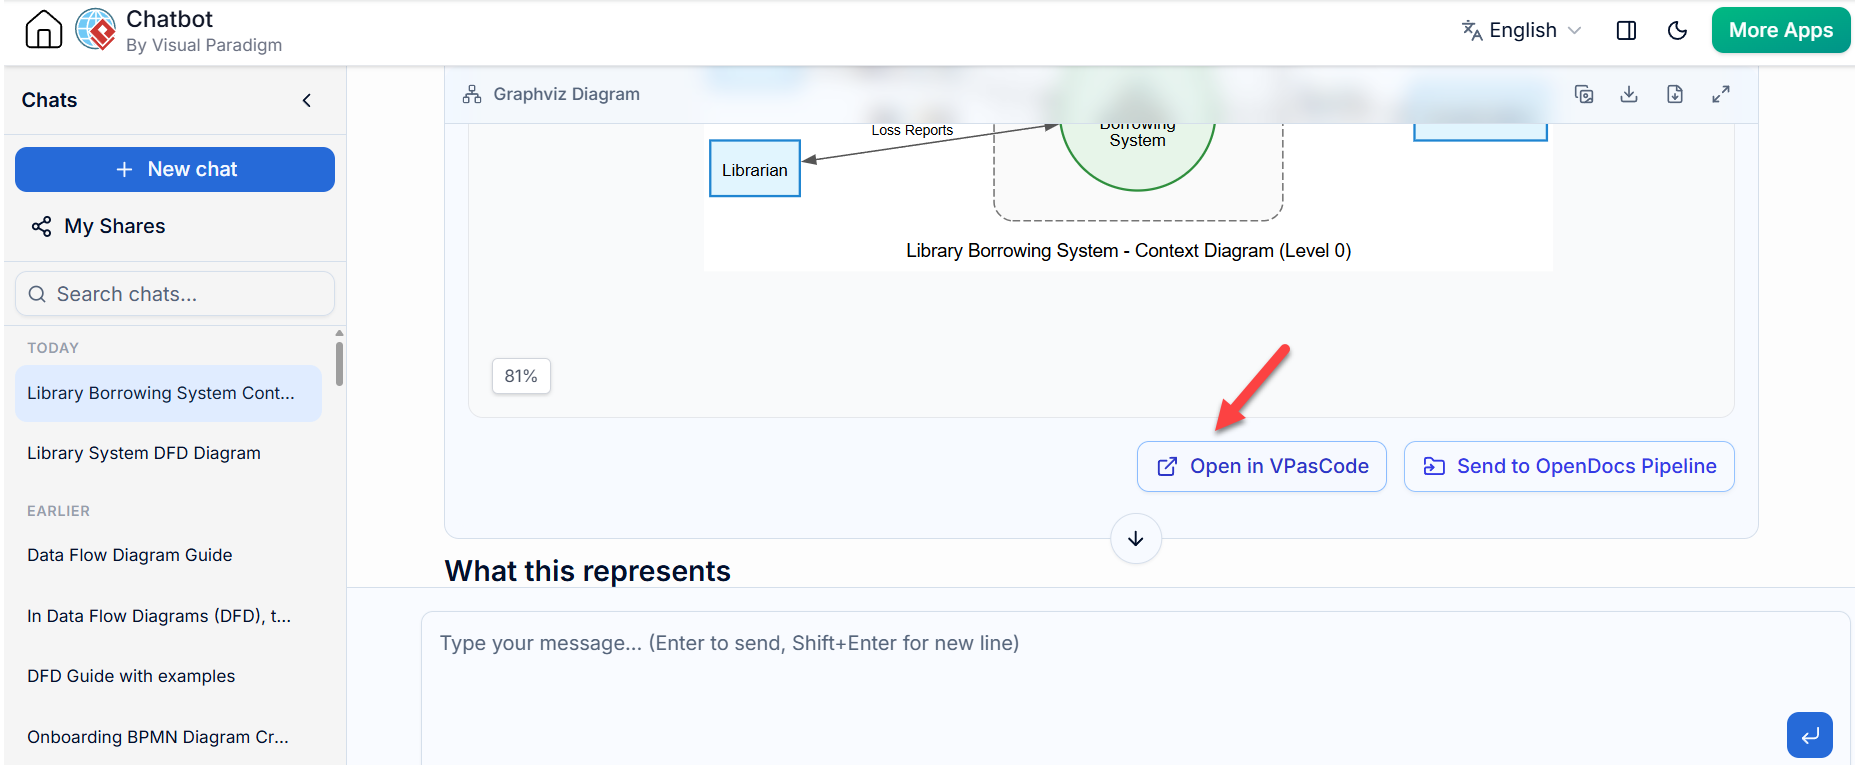
Теперь вы можете изменить его в редакторе VPasCode, отредактировав код Graphviz Dot
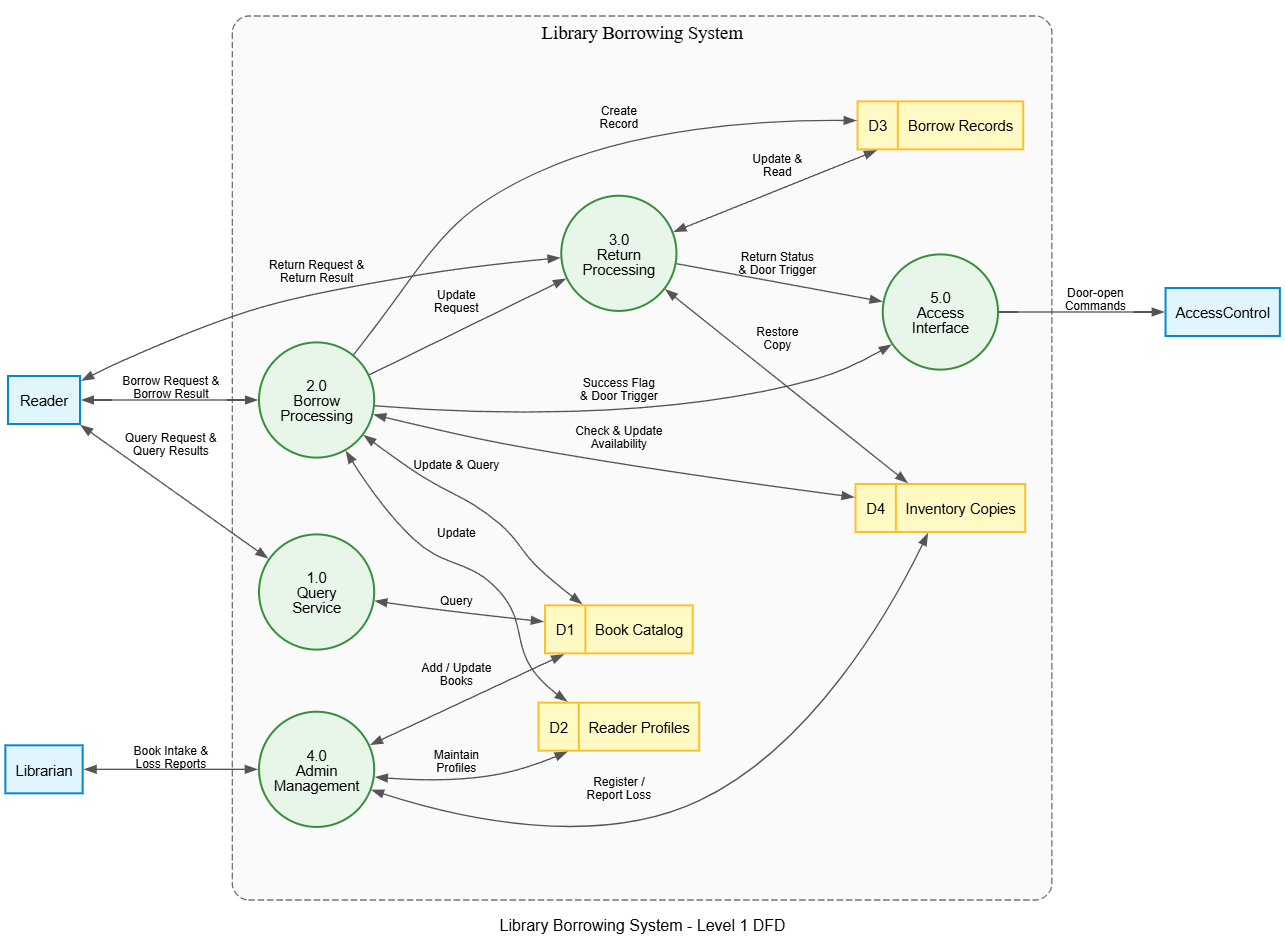
Уровень-0: Функциональная декомпозиция
-
Процессы: 1.0 Сервис запросов, 2.0 Обработка выдачи, 3.0 Обработка возврата, 4.0 Административное управление, 5.0 Интерфейс доступа
-
Хранилища данных: D1 Каталог книг, D2 Профили читателей, D3 Записи о выдаче, D4 Инвентарные экземпляры
-
Проверка соответствия: «Запрос на выдачу» от Читателя соответствует Процессу 2.0; «Команда открытия двери» в Систему контроля доступа соответствует Процессу 5.0; все потоки уровня Контекста учтены.
Уровень-1: Уточнение «2.0 Обработка выдачи»
-
2.1 Проверка запроса: Читает D2; выводит валидный запрос или результат неудачи.
-
2.2 Проверка доступности: Читает D4; выводит информацию о доступном экземпляре или результат недоступности.
-
2.3 Выполнение транзакции: Записывает в D3 (новая запись), обновляет D4 (статус экземпляра), обновляет D2 (количество выданных книг).
-
2.4 Генерация ответа: Генерирует «Результат выдачи» для Читателя и «Сигнал успеха» для Процесса 5.0.
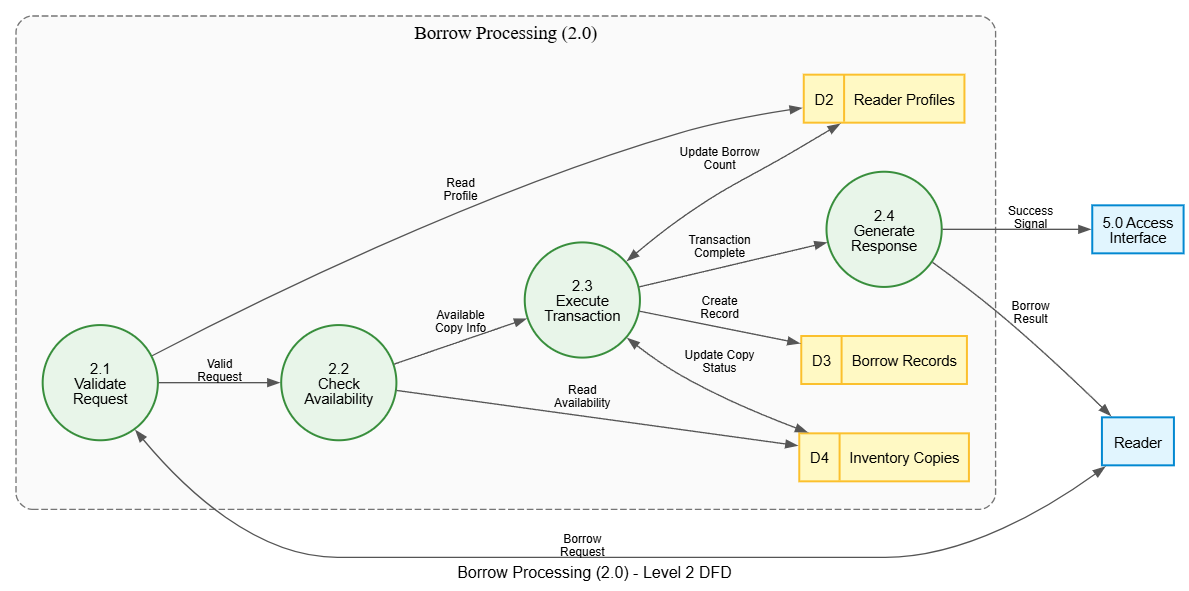
Этот многоуровневый подход превращает неоднозначное требование «взять книгу в библиотеку» в точную спецификацию, показывающую, какие именно таблицы данных затрагиваются, какие правила валидации применяются и где проходят границы транзакций — всё это до написания хотя бы одной строки кода.
4. Продвинутые методы и обеспечение качества
Чек-лист согласованности
После завершения каждого уровня проверьте соответствие следующим критериям:
-
Баланс «родитель-дочерний»: Все внешние потоки сохранены точно.
-
Сохранение данных: Нет «чёрных дыр», чудес или «серых дыр».
-
Использование хранилищ: Каждое хранилище данных имеет как связи для чтения, так и для записи (или задокументированное обоснование инициализации/потребления).
-
Согласованность именования: Одинаковые потоки данных должны иметь одинаковые названия на всех диаграммах. Ведите формальный словарь данных.
-
Равномерность глубины: Асимметричная декомпозиция допустима; останавливайтесь, когда достигнута ясность, а не когда все ветви достигают одинаковой глубины.
Обработка логики управления
DFD моделируют данные, а не управление. Для представления условной логики:
-
Инкапсулируйте решения внутри процессов. Несколько выходных потоков из одного процесса представляют различные исходы (например, «Валидированный запрос» против «Уведомления об отклонении»).
-
Никогда не маркируйте потоки данных как «Да/Нет». Используйте описательные существительные: «Одобренный заказ» против «Отклонённого заказа».
-
Параллельные выходные потоки допустимы и представляют параллельную генерацию данных.
Инструментарий и лучшие практики
-
Рекомендуемые инструменты: Visual Paradigm Online (бесплатный, совместный, богатая библиотека символов); PlantUML/vpAsCode (контроль версий, диаграммы как текст для инженерных команд).
-
Рабочий процесс: Всегда сначала делайте наброски на бумаге/белой доске, чтобы проверить логику перед цифровым оформлением.
-
Тест на простоту: Если диаграмма кажется перегруженной, декомпозируйте её дальше. Соблюдайте правило 7±2.
-
Условные обозначения: Включайте легенду символов на каждую диаграмму для незнакомых с ней читателей.
-
Словарь данных: Ведите отдельный документ, определяющий структуру каждого потока данных и хранилища. Это устраняет двусмысленность и напрямую используется при проектировании базы данных.
-
Дополнительные модели: Диаграммы потоков данных (DFD) отлично подходят для описания преобразования данных, но не для временной последовательности или управления состоянием. Сочетайте их с диаграммами последовательности, машинами состояний или BPMN для полного описания системы.
Заключение
Иерархические диаграммы потоков данных — это не просто нотация; это дисциплина мышления. Каждый слой заставляет вас задавать точные вопросы: Откуда берутся эти данные? Что их преобразует? Где они сохраняются? Что покидает систему? Такая структурированная проверка выявляет скрытые допущения, логические пробелы и неозвученные требования задолго до того, как они превратятся в дорогостоящие ошибки.
Первоначальные инвестиции в изучение и применение методологии DFD приносят экспоненциальную отдачу. При обзоре требований они устраняют двусмысленность. В архитектурных обсуждениях они обеспечивают общий визуальный словарь. При введении в должность они служат самодокументирующимися картами системы. Начинайте с малого, практикуйтесь последовательно и позвольте слоям раскрыть ясность, которую требуют сложные системы. Переход от «запутанного хаоса» к «точному чертежу» начинается с вашей первой контекстной диаграммы.