

Dans le monde rapide du développement logiciel, l’écart entre une grande idée et une fonctionnalité livrable passe souvent par une série complexe de tâches. Lorsqu’une seule histoire utilisateur devient trop grande, elle devient un goulot d’étranglement. Elle ralentit les progrès, masque les risques et rend le test un cauchemar. Ce phénomène est souvent appelé un spike ou un épique déguisé en histoire. Le défi réside dans la capacité à les diviser en éléments gérables sans perdre l’intention initiale ni le fil narratif qui les relie.
Ce guide explore l’art et la science de diviser efficacement les grandes histoires utilisateur. Nous examinerons des stratégies pour préserver le contexte, garantir que chaque tranche apporte de la valeur et maintenir l’alignement de l’équipe. En maîtrisant les mécanismes de décomposition, les équipes peuvent améliorer la prévisibilité et la qualité sans sacrifier la vision globale du produit.
⚠️ Le coût caché des histoires trop grandes
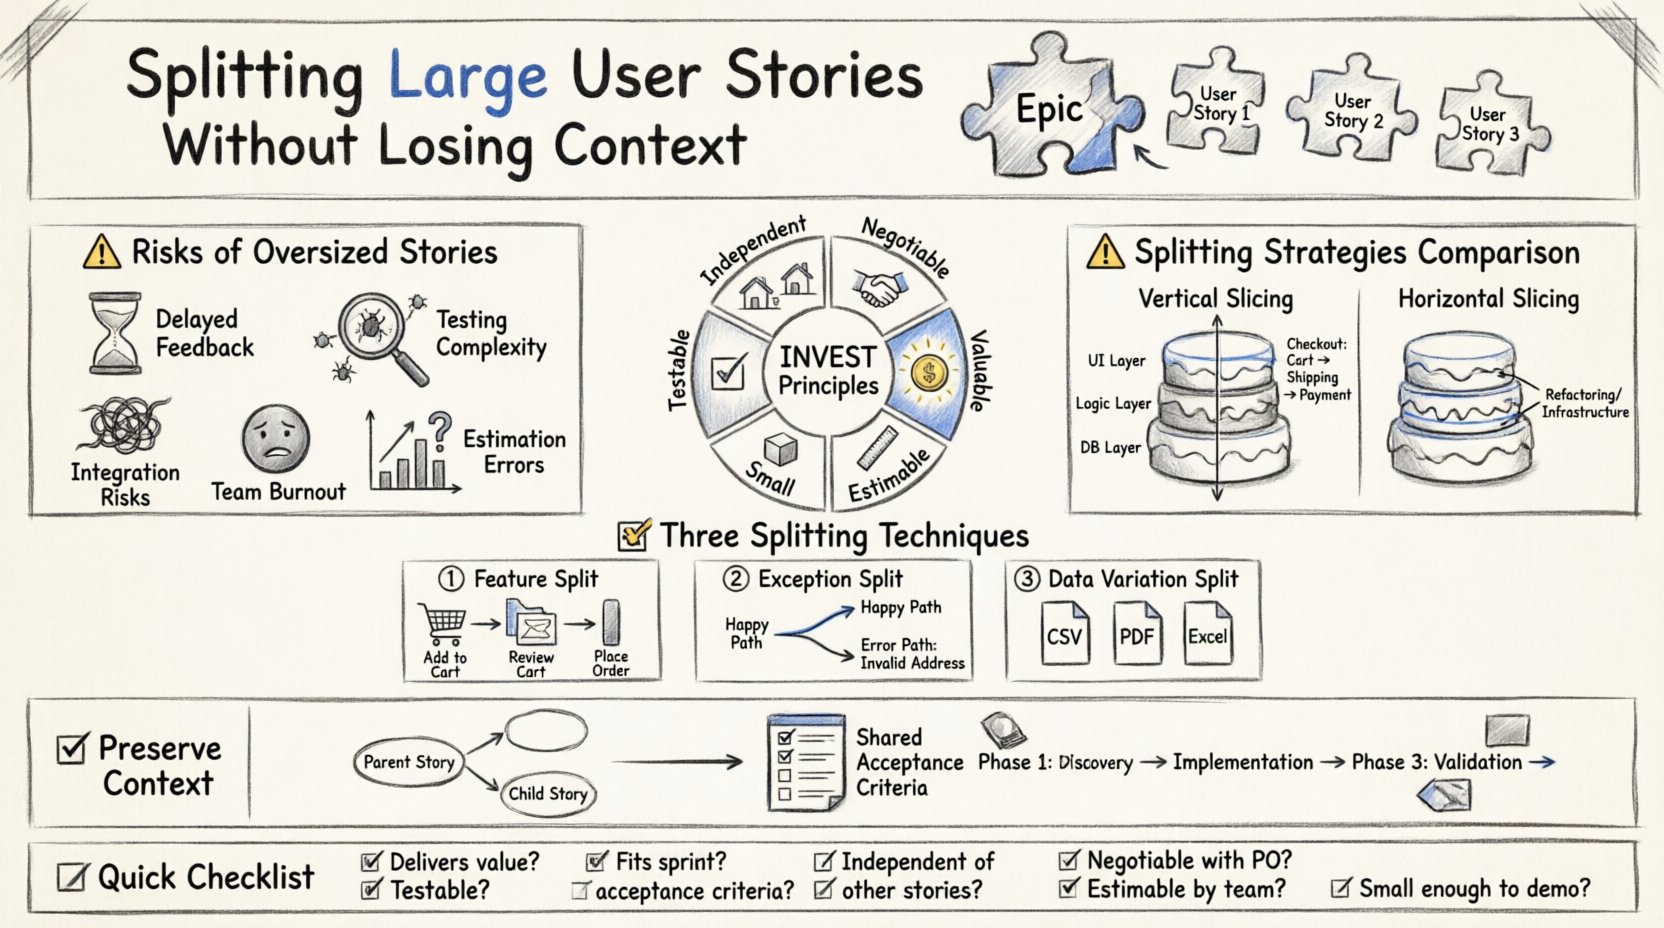
Avant de plonger dans les solutions, il est crucial de comprendre pourquoi les grandes histoires posent problème. Une histoire trop grande échoue au test du temps. Elle ne peut pas être terminée en une seule itération, ce qui entraîne des travaux partiels bloqués dans un état de flux. Cela génère une dette technique et de l’incertitude.
Pensez aux risques liés au maintien d’histoires grandes :
- Retard de retour : Les parties prenantes ne voient pas de logiciel fonctionnel avant la toute fin du cycle. À ce moment-là, la direction peut avoir changé.
- Complexité du test : Les équipes QA peinent à valider un ensemble massif de fonctionnalités d’un coup. Les cas limites se multiplient de façon exponentielle.
- Risques d’intégration : Combiner plusieurs composants non testés augmente la probabilité de conflits dans la base de code.
- Surmenage de l’équipe : Travailler sur une tâche monolithique pendant des semaines épuise la motivation. L’absence de petites victoires décourage l’équipe.
- Erreurs d’estimation : Les grandes histoires sont intrinsèquement difficiles à estimer avec précision. Cela entraîne des délais manqués et une vitesse réduite.
Pour atténuer ces problèmes, les équipes doivent adopter une approche disciplinée de la décomposition. L’objectif n’est pas seulement de rendre les tâches plus petites, mais de leur donner de la valeur.
🧱 Principes fondamentaux pour une division efficace
La division n’est pas aléatoire. Elle exige l’adhésion à des principes spécifiques qui garantissent que les histoires résultantes restent utiles. Le cadre le plus reconnu pour cela est le modèle INVEST modèle. Lors de la division, chaque nouvelle histoire devrait idéalement répondre à ces critères :
- Indépendante : L’histoire ne doit pas dépendre d’autres histoires pour être fonctionnelle.
- N
- Valuable : Chaque tranche doit apporter de la valeur à l’utilisateur ou au donneur d’ordre.
- E
- SPetit : Il doit tenir dans un sprint.
- TStable : Des critères d’acceptation clairs doivent exister.
Lorsqu’une histoire est divisée, le Valeurcritère est le plus important. Une histoire divisée qui ne peut pas fonctionner seule ne fournit aucune valeur. Si l’utilisateur ne peut pas utiliser la fonctionnalité, la division était incorrecte.
📊 Comparaison des critères de division
| Critère | Focus | Application exemple |
|---|---|---|
| Découpage vertical | Fonctionnalité bout en bout | Ajouter un seul nouveau champ à un formulaire et l’afficher. |
| Découpage horizontal | Implémentation par couches | Refactoring du schéma de base de données pour l’ensemble du système. |
| Gestion des exceptions | Cas limites et erreurs | Gérer les délais d’attente réseau ou les entrées de données non valides. |
| Variations des données | Différences de contenu | Prise en charge de différentes devises ou langues. |
🔪 Stratégies pour le découpage vertical
Le découpage vertical est la norme d’or pour diviser les histoires utilisateur. Il consiste à couper à travers toutes les couches de l’application (base de données, logique métier, interface utilisateur) afin de livrer une fonctionnalité spécifique et fonctionnelle. Cela garantit que chaque histoire produit un incrément déployable.
1. La division par fonctionnalité
Si une histoire décrit un flux de travail complexe, divisez-la en fonction des actions spécifiques que l’utilisateur peut effectuer. Au lieu de construire l’ensemble du processus de paiement d’un coup, isolez les étapes individuelles.
- Histoire originale : En tant qu’acheteur, je veux finaliser un achat afin de pouvoir acheter des articles.
- Split 1 : En tant qu’acheteur, je souhaite ajouter des articles à un panier afin de pouvoir examiner mon choix.
- Split 2 : En tant qu’acheteur, je souhaite saisir les coordonnées de livraison afin de pouvoir passer à paiement.
- Split 3 : En tant qu’acheteur, je souhaite sélectionner un mode de paiement afin de finaliser la commande.
Chacun de ces éléments est une valeur autonome. Le panier fonctionne sans livraison. La livraison fonctionne sans paiement (à des fins de prévisualisation). Cela permet des déploiements incrémentaux.
2. La séparation des exceptions
Souvent, le parcours normal est simple, mais les cas limites rendent une histoire complexe. Séparer le parcours normal du parcours d’exception peut clarifier les exigences et réduire les risques.
- Histoire originale : En tant qu’utilisateur, je souhaite réinitialiser mon mot de passe afin de pouvoir récupérer l’accès.
- Split 1 (Parcours normal) : En tant qu’utilisateur, je souhaite recevoir un lien de réinitialisation par e-mail afin de pouvoir modifier mon mot de passe.
- Split 2 (Exception) : En tant qu’utilisateur, je souhaite être informé si mon e-mail n’est pas trouvé afin de pouvoir corriger mon entrée.
- Split 3 (Exception) : En tant qu’utilisateur, je souhaite verrouiller mon compte après plusieurs tentatives échouées afin qu’il reste sécurisé.
3. La séparation par variation de données
Le support de différents types de données gonfle souvent une histoire. En isolant les types de données, les équipes peuvent simplifier la validation et la logique.
- Histoire originale : En tant qu’administrateur, je souhaite télécharger des rapports au format CSV, PDF et Excel.
- Split 1 : En tant qu’administrateur, je souhaite télécharger des rapports CSV.
- Split 2 : En tant qu’administrateur, je souhaite télécharger des rapports PDF.
- Split 3 : En tant qu’administrateur, je souhaite télécharger des rapports Excel.
🏗️ Quand utiliser la découpe horizontale
La découpe verticale n’est pas toujours la solution. Parfois, une découpe horizontale est nécessaire. Elle consiste à construire progressivement les fonctionnalités au travers de l’ensemble du système. Bien qu’elle ne produise pas de valeur immédiate pour l’utilisateur, elle est utile pour les fondations techniques.
Utilisez la découpe horizontale lorsque :
- Refactoring : Vous devez mettre à jour une bibliothèque utilisée par chaque fonctionnalité.
- Infrastructure : Vous êtes en train de mettre en place un nouveau schéma de base de données ou une passerelle API.
- Sécurité : Vous êtes en train d’implémenter l’authentification sur l’ensemble de l’application.
- Performance : Vous êtes en train d’optimiser la couche de mise en cache pour tous les points d’entrée.
Même en utilisant des tranches horizontales, essayez de les garder suffisamment petites pour pouvoir être testées de manière indépendante. Une division horizontale qui touche chaque module doit toujours être traitée comme une seule histoire.
🧭 Préserver le contexte pendant la décomposition
Le risque le plus important dans la division est de perdre le contexte. Si un membre de l’équipe prend une petite histoire sans comprendre comment elle s’inscrit dans le tableau global, l’implémentation peut s’éloigner de la vision initiale. Cela est connu sous le nom de changement de contexte ou fragmentation.
1. Lier les histoires entre elles
Utilisez des relations parent-enfant dans le système de gestion du backlog. Marquez l’histoire initiale grande comme un épisode ou parent. Chaque histoire divisée doit référencer l’ID du parent. Cela crée une chaîne de traçabilité.
- Épisode : Mettre en œuvre la gestion du profil utilisateur.
- Histoire A : Ajouter le téléchargement de la photo de profil.
- Histoire B : Mettre à jour les informations de contact.
- Histoire C : Modifier les paramètres du mot de passe.
Cette structure garantit que, lors de la revue de l’histoire A, le développeur voit que les histoires B et C sont à venir. Elle fournit une feuille de route pour l’ensemble de la fonctionnalité.
2. Critères d’acceptation partagés
Certaines règles s’appliquent à l’ensemble de la fonctionnalité, et non seulement à la tranche. Définissez-les dans un document partagé ou dans une section commune du modèle d’histoire. Cela garantit la cohérence.
- Sécurité : Toutes les mises à jour de profil doivent exiger une nouvelle authentification.
- Performance : Le temps de chargement de la page doit rester inférieur à 2 secondes.
- Accessibilité : Tous les champs de formulaire doivent avoir des étiquettes appropriées pour les lecteurs d’écran.
En les listant globalement, chaque histoire fractionnée hérite des contraintes. Cela empêche une tranche de introduire une faille de sécurité qui affecte l’ensemble.
3. Cartographie visuelle
La cartographie des histoires utilisateurs est une technique puissante pour visualiser le flux. Créez une liste de tâches utilisateur sur l’axe horizontal et les histoires qui les soutiennent sur l’axe vertical. Cela crée un squelette de la fonctionnalité.
Cette carte sert de contrat visuel. Lorsqu’on fractionne une histoire, l’équipe peut consulter la carte pour voir ce qui précède et ce qui suit. Cela empêche l’équipe de développer une histoire en isolation, ce qui romprait le flux du parcours utilisateur.
🚫 Pièges courants à éviter
Même avec de bonnes intentions, la fractionnement peut mal tourner. Voici les erreurs courantes que les équipes commettent en essayant de réduire la taille des histoires.
- Sur-fractionnement : Rendre les histoires si petites qu’elles ne prennent que 2 heures à accomplir. Cela augmente la charge des réunions et des mises à jour. Visez des histoires qui prennent entre 1 et 3 jours.
- Fractionnement par technologie : Ne fractionnez pas une histoire uniquement parce qu’elle implique une tâche côté serveur et une tâche côté client. Si la tâche côté client nécessite que la tâche côté serveur soit terminée en premier, il s’agit d’une dépendance, pas d’un fractionnement par valeur. Cela crée un modèle en cascade au sein de la sprint.
- Perte de l’utilisateur : Fractionner les histoires en tâches techniques (par exemple, « Créer une table de base de données ») sans énoncé de valeur utilisateur (par exemple, « En tant qu’utilisateur, je veux sauvegarder mon avancement »).
- Ignorer les dépendances : Oublier de vérifier si une histoire fractionnée bloque une autre. Cela entraîne des temps d’inactivité pour les membres de l’équipe.
- Critères d’acceptation en double : Copier-coller les critères d’acceptation sans les mettre à jour pour la tranche spécifique. Cela entraîne de la confusion lors des tests.
📋 Liste de contrôle pour le fractionnement des histoires
Avant de finaliser un fractionnement, passez en revue cette liste de contrôle pour garantir qualité et clarté.
- ☐ Cette histoire fractionnée apporte-t-elle une valeur indépendante ?
- ☐ Peut-elle être testée de manière isolée ?
- ☐ L’estimation de l’effort est-elle réaliste pour une itération ?
- ☐ Les dépendances sont-elles clairement identifiées ?
- ☐ L’histoire est-elle liée à l’épisode parent ?
- ☐ Les critères d’acceptation sont-ils spécifiques à cette tranche ?
- ☐ Conserve-t-elle le contexte du parcours utilisateur ?
- ☐ Avons-nous envisagé les chemins d’exception ?
🔄 Techniques de révision
La découpe n’est pas un événement ponctuel. C’est une conversation continue pendant la révision du backlog. Au fur et à mesure que l’équipe en apprend davantage sur le problème, les histoires peuvent nécessiter une découpe supplémentaire ou une fusion.
1. Le débat sur le « comment » versus le « quoi »
Assurez-vous que l’histoire se concentre sur le quoi (valeur pour l’utilisateur) plutôt que sur le comment (implémentation technique). Si une histoire est grande parce que l’équipe ne sait pas comment la construire, il s’agit d’un spike, et non d’une histoire. Séparez le spike en une tâche de recherche.
- Mauvais : En tant qu’utilisateur, je veux que le système utilise le cache Redis pour des lectures plus rapides.
- Bon : En tant qu’utilisateur, je veux que le tableau de bord se charge en moins d’une seconde.
- Spike de recherche : Évaluer les options d’implémentation de Redis et estimer l’effort.
2. Révision itérative
Commencez par une découpe approximative. Au début de l’itération, l’équipe peut se rendre compte qu’une tranche est encore trop grande. Il est acceptable de découper une histoire pendant l’itération si le risque est trop élevé. Cependant, cela doit être rare. Des séances régulières de révision avant la planification de l’itération aident à éviter cela.
🤔 Questions fréquemment posées
Voici les questions courantes posées par les équipes lorsqu’elles traitent des grandes histoires.
Q : Comment savoir quand une histoire est trop grande ?
R : Si l’équipe ne parvient pas à s’entendre sur une estimation, ou si l’histoire nécessite plus d’une itération pour être terminée, elle est trop grande. De plus, si le test semble accablant, elle est probablement trop volumineuse.
Q : Devrais-je découper les histoires en fonction de qui effectue le travail ?
R : Non. Découper par rôle (par exemple, « Tâche frontend », « Tâche backend ») crée des dépendances. Découpez par valeur ou fonctionnalité afin que n’importe quel membre de l’équipe puisse reprendre le travail et le faire avancer.
Q : Et si le client veut toute la fonctionnalité d’un coup ?
R : Communiquez les risques. Expliquez que livrer par tranches permet un retour plus rapide et réduit les chances de construire la mauvaise chose. Proposez d’abord la plus petite tranche qui apporte le bénéfice principal.
Q : Toutes les histoires doivent-elles être verticales ?
R : La plupart devraient l’être. Les tranches verticales apportent de la valeur. Les tranches horizontales sont destinées à la dette technique ou à l’infrastructure. Si une tranche horizontale est trop grande, divisez-la par composant ou module, mais assurez-vous qu’elle reste une histoire technique.
🏁 Réflexions finales
Scinder de grandes histoires utilisateur est un exercice d’équilibre. Il demande du jugement, de l’expérience et une communication claire. L’objectif n’est pas seulement de réduire la taille du travail, mais de le rendre plus pertinent. Lorsqu’il est bien fait, le découpage réduit les risques, améliore la qualité et maintient l’équipe concentrée sur ce qui compte pour l’utilisateur.
En respectant les principes du découpage vertical, en maintenant le contexte grâce au lien et à la cartographie, et en évitant les pièges courants, les équipes peuvent naviguer avec confiance dans des fonctionnalités complexes. Le résultat est un flux constant de logiciel fonctionnel et un intervenant satisfait. Continuez à affiner votre approche, et laissez les données de vos sprints guider vos décisions futures de découpage.

