

Einführung
1. Die Kernbausteine: Das DFD „Vokabular“
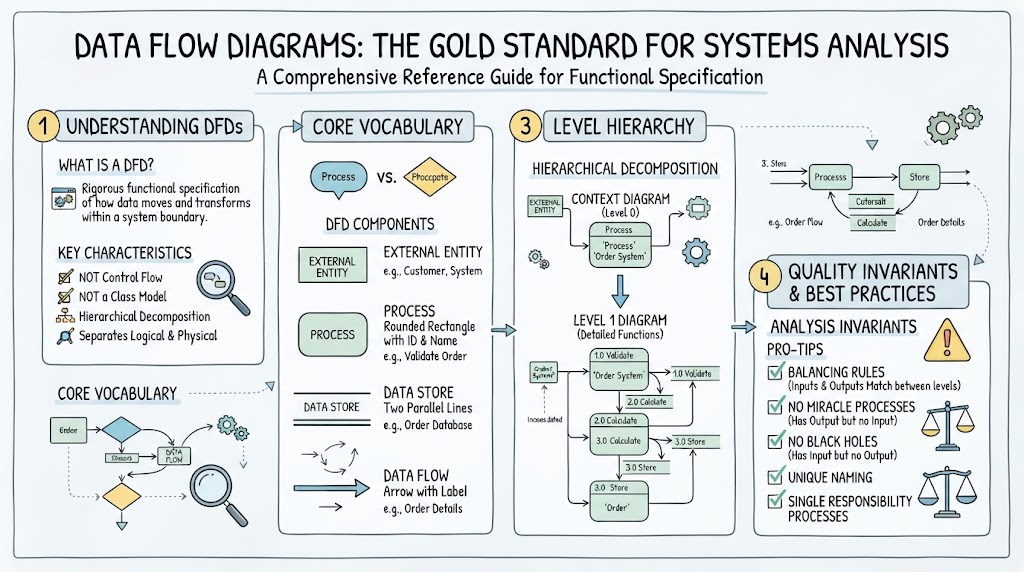
Bevor Sie in Ebenen und Typen eintauchen, benötigen Sie die vier grundlegenden Symbole, aus denen jedes DFD besteht. Diese sind in allen Notationen (Yourdon/DeMarco, Gane & Sarson, SSADM) konsistent – sie unterscheiden sich nur in Form.
| Element | Zweck | Form nach Gane & Sarson | Form nach Yourdon/DeMarco |
|---|---|---|---|
| Externe Entität (Terminator) | Eine Quelle oder Senke außerhalbdes Systems – eine Person, Organisation oder ein externes System, das Daten liefert oder verbraucht | Abgerundetes Rechteck | Quadrat / Kasten |
| Prozess | Transformiert Eingaben in Ausgaben. Immer mit einem Verb benannt und nummeriert | Abgerundetes Rechteck | Kreis (Blase) |
| Datenspeicher | Wo Daten im Ruhezustand gespeichert werden – eine Datei, eine Datenbank oder ein Repository | Offenes Rechteck | Zwei parallele Linien |
| Datenfluss | Ein benannter Pfeil, der die Datenbewegung zwischen Elementen zeigt | Pfeil mit Beschriftung | Pfeil mit Beschriftung |
Namenskonventionen (entscheidend für Klarheit):
-
Prozesse: Nummer + Verbphrase →
1.0 Bestellung validieren,2.0 Lagerbestand prüfen. Die Nummerierung ermöglicht die Zerlegung (Prozess2.0wird unterteilt in2.1,2.2,2.3…). -
Datenspeicher: Nummer + Nominalphrase →
D1 Kunde,D2 Lagerbestand. -
Datenflüsse: eine kurze Beschreibung des Dateninhalts →
Bestellanforderung,Zahlungsüberprüfung,Lagerbestandsermittlung.
2. Die Ebenenhierarchie (Abstraktion durch Zerlegung)
Die Kernidee von gestuften DFDs ist Top-down-Zerlegung: Sie beginnen mit einer einzigen undurchsichtigen Blase und setzen deren Internes rekursiv frei, bis jeder Prozess trivial einfach ist.
2.1 Kontextdiagramm (Ebene 0)
-
Abstraktion: Höchstmöglich — das gesamte System ist ein einziger Prozess.
-
Was es zeigt: Externe Entitäten und die Datenflüsse, die sie mit der einzigen Systemblase verbinden. Mehr nicht.
-
Was es bewusst verbirgt: Jeder interne Prozess, jedes Datenspeicher und alle Datenflüsse innerhalb des Systems.
-
Zweck: Definiert die Systemgrenze — die klare Linie zwischen „was drinnen ist“ und „was draußen ist“.
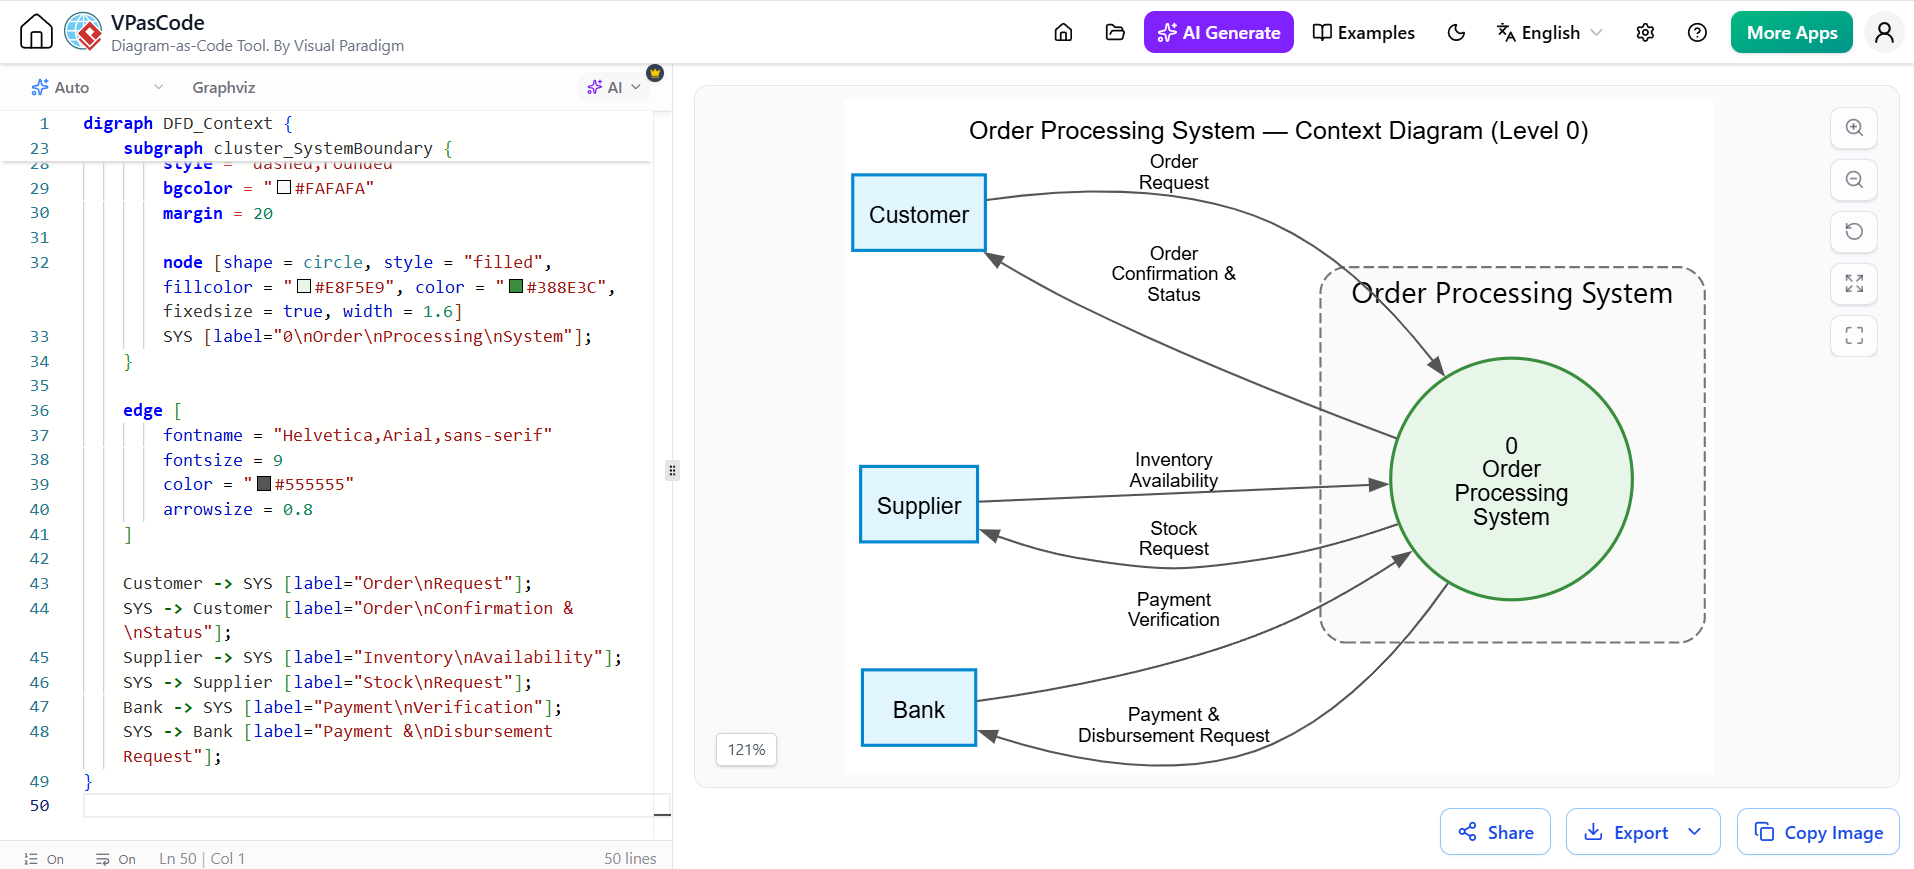
Unten finden Sie ein Kontextdiagramm für ein Auftragsbearbeitungssystem. Beachten Sie, wie das gesamte System als Prozess erscheint 0, und alle Details werden an die externe Welt weitergegeben:
digraph DFD_Context {
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 1.2
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Auftragsbearbeitungssystem — Kontextdiagramm (Ebene 0)"
        labelloc = t
    ]

    node [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 11
        penwidth = 1.5
    ]

    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Customer; Supplier; Bank;

    subgraph cluster_SystemBoundary {
        label = "Auftragsbearbeitungssystem";
        fontname = "Helvetica,Arial,sans-serif; bold"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        node [shape = circle, style = "filled", fillcolor = "#E8F5E9", color = "#388E3C", fixedsize = true, width = 1.6]
        SYS [label="0nAuftragsnBearbeitungnSystem"];
    }

    edge [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 9
        color = "#555555"
        arrowsize = 0.8
    ]

    Customer -> SYS [label="AuftragsnAnfrage"];
    SYS -> Customer [label="AuftragsnBestätigung &nStatus"];
    Supplier -> SYS [label="LagernVerfügbarkeit"];
    SYS -> Supplier [label="LagernAnfrage"];
    Bank -> SYS [label="ZahlungsnVerifizierung"];
    SYS -> Bank [label="Zahlung &nAuszahlungsanfrage"];
}
Lesen Sie die Grenze: In diesem Kontextdiagramm ist das System tut nichts Sichtbares — aber jede externe Interaktion ist aufgezählt. Dieses Artefakt ist der Vertrag, den Sie mit den Stakeholdern unterzeichnet haben: es erfasst Umfang und verhindert Scope Creep, da alles, was nicht auf diesem Diagramm steht, außerhalb des Umfangs liegt.
2.2 Ebene-1-DFD
-
Abstraktion: Zerlegt den einzelnen
0Prozess in seine Haupt-Teilprozesse. -
Was es zeigt: Die primären Funktionsbereiche, wichtigen Datenspeicher und wie Daten zwischen ihnen, den Speichern und den externen Entitäten fließen.
-
Zweck: Gibt den ersten echten Einblick in Systemstruktur. Die Hauptfunktionen sind nun sichtbar.
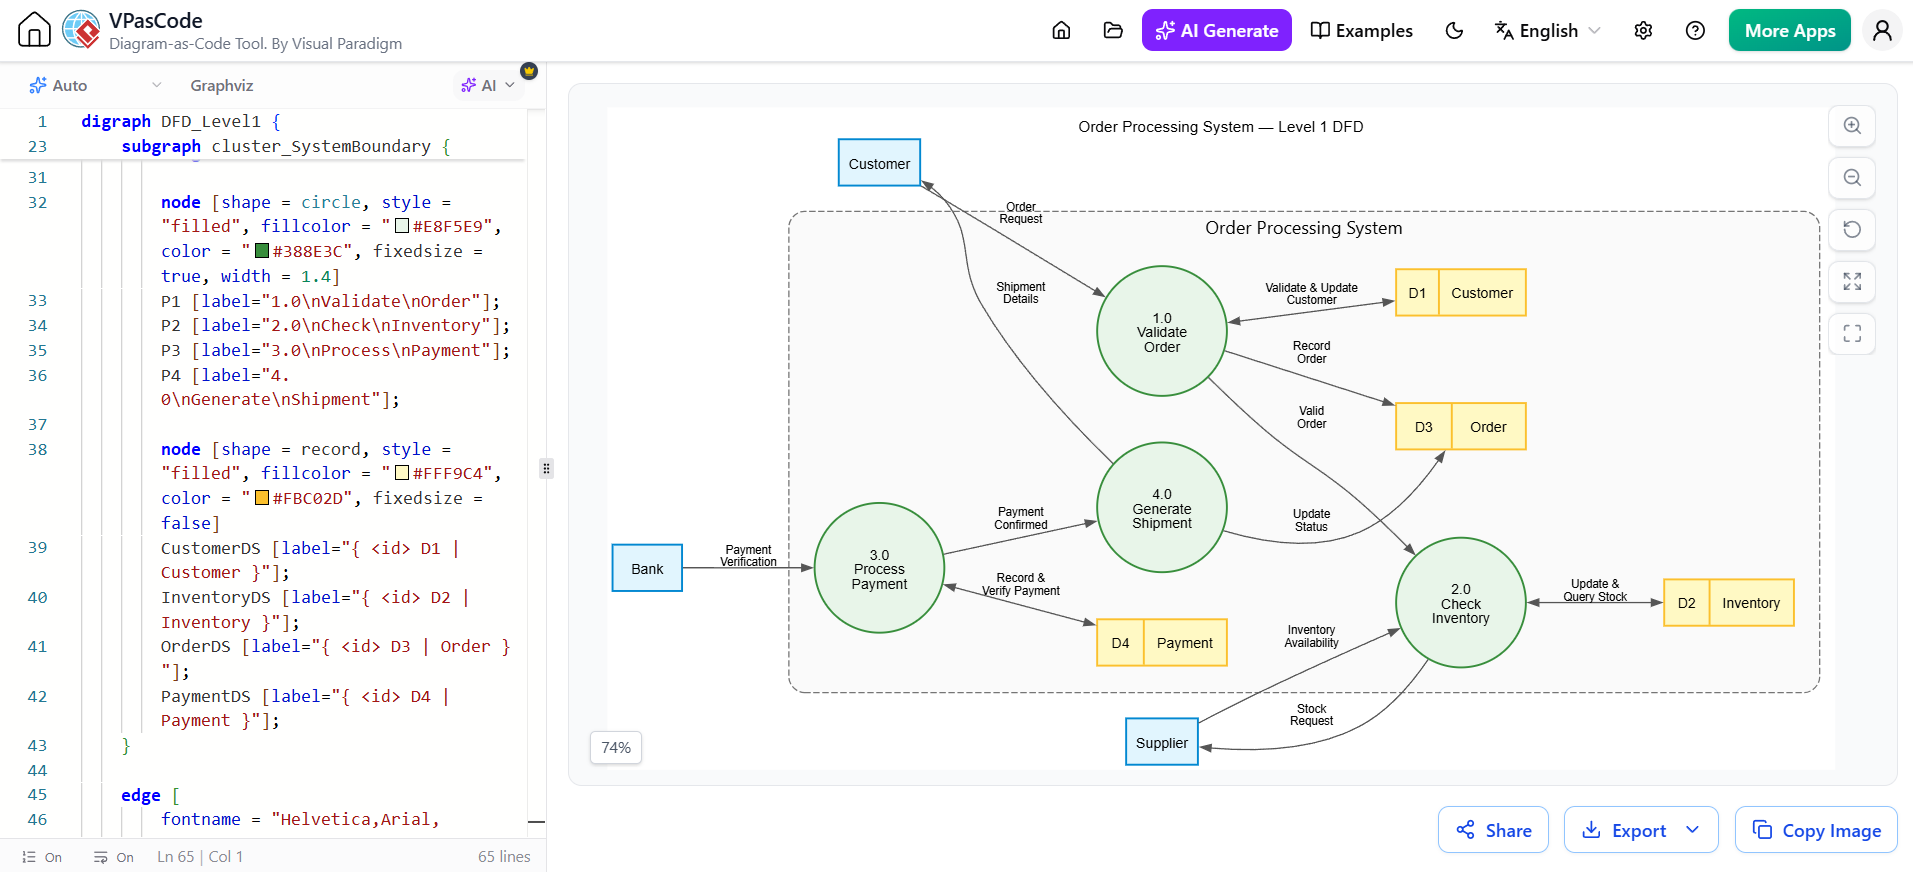
Für das Auftragsbeispiel zerlegt der Prozess 0 in vier Hauptfunktionen: Bestellung validieren, Lagerbestand prüfen, Zahlung bearbeiten, und Versand erstellen. Beachten Sie, dass Datenspeicher hier zum ersten Mal erscheinen:
digraph DFD_Level1 {
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Bestellverarbeitungssystem — Level-1-DFD"
        labelloc = t
    ]

    node [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 11
        penwidth = 1.5
    ]

    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Kunde; Lieferant; Bank;

    subgraph cluster_SystemBoundary {
        label = "Bestellverarbeitungssystem";
        fontname = "Helvetica,Arial,sans-serif; bold"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        node [shape = circle, style = "filled", fillcolor = "#E8F5E9", color = "#388E3C", fixedsize = true, width = 1.4]
        P1 [label="1.0nValidierennBestellung"];
        P2 [label="2.0nLagerbestandnprüfen"];
        P3 [label="3.0nZahlungnbearbeiten"];
        P4 [label="4.0nVersandnerstellen"];

        node [shape = record, style = "filled", fillcolor = "#FFF9C4", color = "#FBC02D", fixedsize = false]
        CustomerDS [label="{ <id> D1 | Kunde }"];
        InventoryDS [label="{ <id> D2 | Lagerbestand }"];
        OrderDS [label="{ <id> D3 | Bestellung }"];
        PaymentDS [label="{ <id> D4 | Zahlung }"];
    }

    edge [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 9
        color = "#555555"
        arrowsize = 0.8
    ]

    Kunde -> P1 [label="Bestellnanfrage"];
    Bank -> P3 [label="Zahlungsnüberprüfung"];
    Lieferant -> P2 [label="Lagernverfügbarkeit"];
    P1 -> P2 [label="GültigenBestellung"];
    P3 -> P4 [label="Zahlungnbestätigt"];
    P1 -> CustomerDS [label="Validieren & AktualisierennKunde", dir=both];
    P2 -> InventoryDS [label="Aktualisieren &nLagerbestand abfragen", dir=both];
    P1 -> OrderDS [label="Bestellungnregistrieren"];
    P3 -> PaymentDS [label="Zahlungnregistrieren & überprüfen", dir=both];
    P4 -> OrderDS [label="Statusnaktualisieren"];
    P2 -> Lieferant [label="Lagernanfrage"];
    P4 -> Kunde [label="Versandndetails"];
}
Wichtige Vorgänge hier, auf die Sie immer achten sollten:
-
Die Nummerierung ist konsistent (
1.0…4.0) passend zum übergeordneten Prozess0. -
Ausgewogenheit (nachfolgend beschrieben) — die Flüssein und aus Prozess
0im Kontextdiagramm müssen den Flüssen entsprechenin und aus dem Level-1-Diagramm als Ganzes. -
Zweiseitiger Speicherzugriff (z. B.
P1 -> CustomerDS [dir=both]) wird als eine einzige, zusammengeführte Kante gezeichnet und nicht als zwei überladene Pfeile.
2.3 DFD der Ebene 2 (und darüber hinaus)
-
Abstraktion: Weitere Zerlegung eines einzelnen Prozesses der Ebene 1.
-
Was es zeigt: Granulare Details für komplexe Prozesse. Jeder Teilprozess erhält eine atomare Funktion.
-
Zweck: Sie fahren fort, Ebenen 3, Ebene 4 usw. zu erstellen, bis jeder Blattprozess einfach genug ist, um in einer kurzen Beschreibung oder Pseudocode — dieser Endprozess wird als funktionales Primitivum (ein Primitivprozess).
Hier zoomen wir in Prozess 2.0 Inventar prüfen aus dem DFD der Ebene 1 und zerlegen ihn in 2.1 Lagerbestand abfragen, 2.2 Verfügbarkeit prüfen, und 2.3 Lagerbestand reservieren:
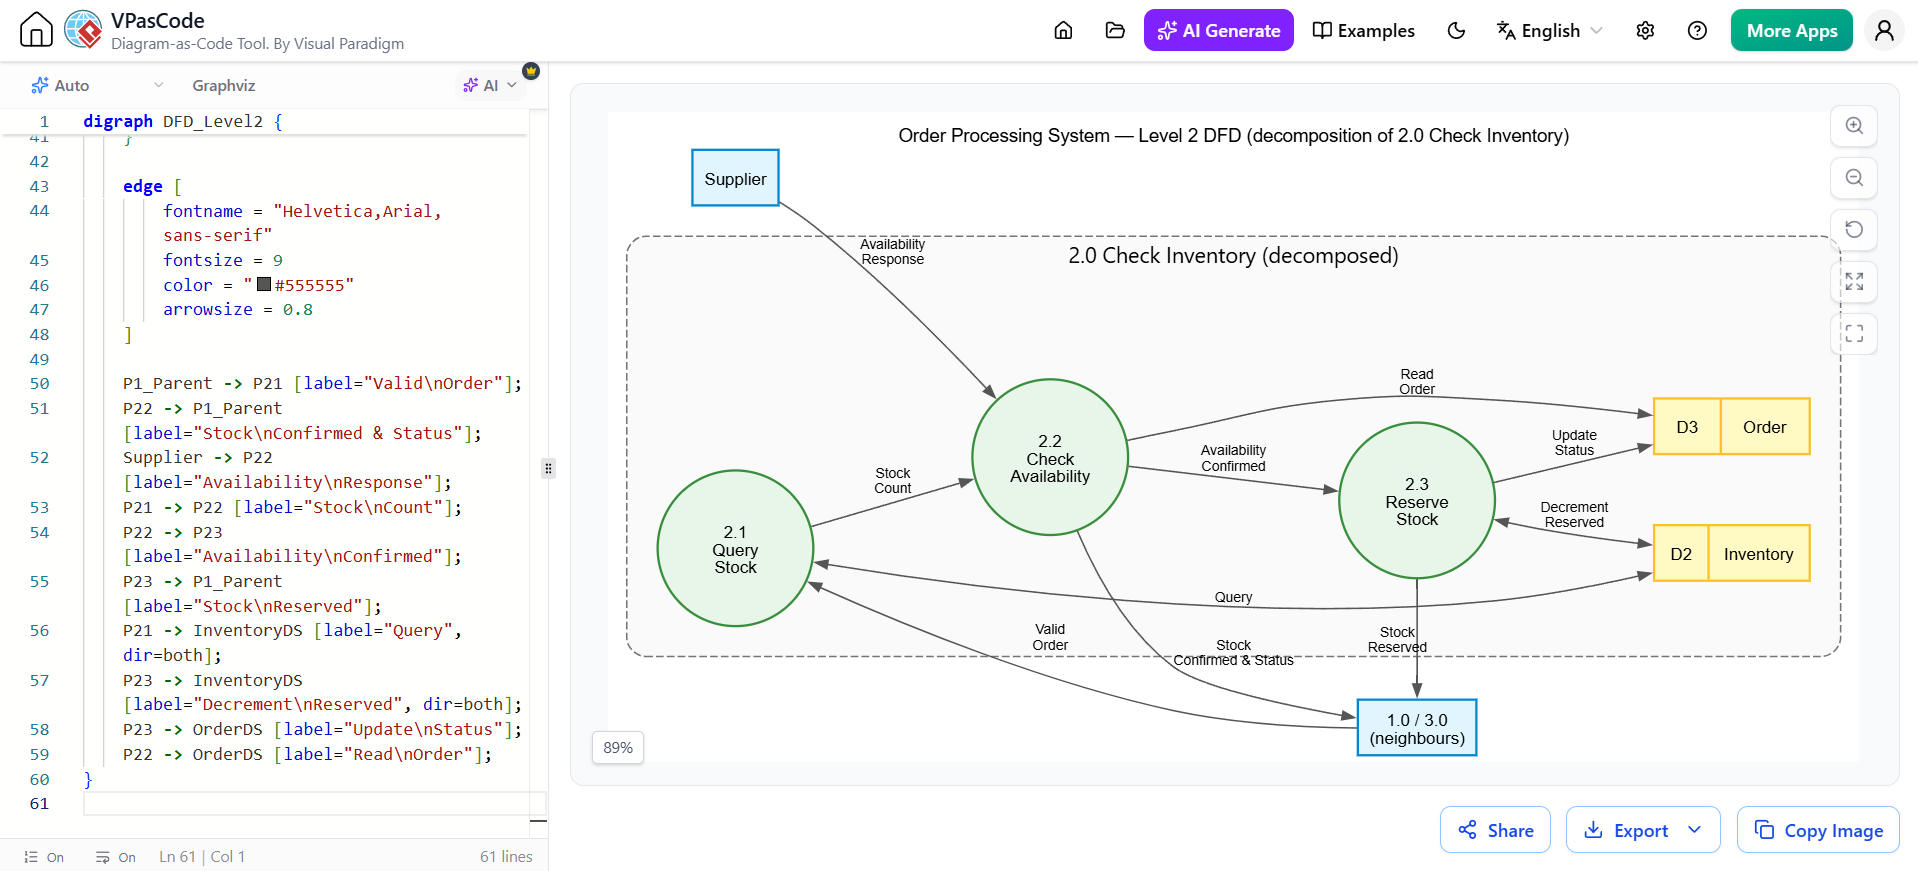
digraph DFD_Level2 {
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.4
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Auftragssystem — Level-2-DFD (Dekomposition von 2.0 Lagerbestand prüfen)"
        labelloc = t
    ]

    node [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 11
        penwidth = 1.5
    ]

    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    P1_Parent [label="1.0 / 3.0n(Nachbarn)"];
    Supplier;

    subgraph cluster_SystemBoundary {
        label = "2.0 Lagerbestand prüfen (dekomponiert)";
        fontname = "Helvetica,Arial,sans-serif; bold"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        node [shape = circle, style = "filled", fillcolor = "#E8F5E9", color = "#388E3C", fixedsize = true, width = 1.4]
        P21 [label="2.1nAbfragenLagerbestand"];
        P22 [label="2.2nVerfügbarkeitnprüfen"];
        P23 [label="2.3nLagerbestandnreservieren"];

        node [shape = record, style = "filled", fillcolor = "#FFF9C4", color = "#FBC02D", fixedsize = false]
        InventoryDS [label="{ <id> D2 | Lagerbestand }"];
        OrderDS [label="{ <id> D3 | Auftrag }"];
    }

    edge [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 9
        color = "#555555"
        arrowsize = 0.8
    ]

    P1_Parent -> P21 [label="GültigernAuftrag"];
    P22 -> P1_Parent [label="Lagerbestandnbestätigt & Status"];
    Supplier -> P22 [label="VerfügbarkeitsnAntwort"];
    P21 -> P22 [label="LagerbestandnAnzahl"];
    P22 -> P23 [label="Verfügbarkeitnbestätigt"];
    P23 -> P1_Parent [label="Lagerbestandnreserviert"];
    P21 -> InventoryDS [label="Abfrage", dir=both];
    P23 -> InventoryDS [label="Reservierungnabziehen", dir=both];
    P23 -> OrderDS [label="Statusnaktualisieren"];
    P22 -> OrderDS [label="Auftragnlesen"];
}
Wann hören Sie auf? Die Faustregel: Fahren Sie mit der Dekomposition fort, bis jeder Blattprozess ein funktionales Primitiv — ein Prozess, der einfach genug ist, um vollständig durch ein paar Zeilen Pseudocode oder eine kurze Benutzerstory spezifiziert zu werden. Es gibt kein festes Zielniveau; die Komplexität bestimmt die Tiefe. Ein kleiner Prozess kann bereits auf Ebene 1 ein Primitiv sein; ein großer Prozess kann Ebene 3 oder 4 benötigen.
3. Logische vs. physische DFDs — Die Absicht Dimension
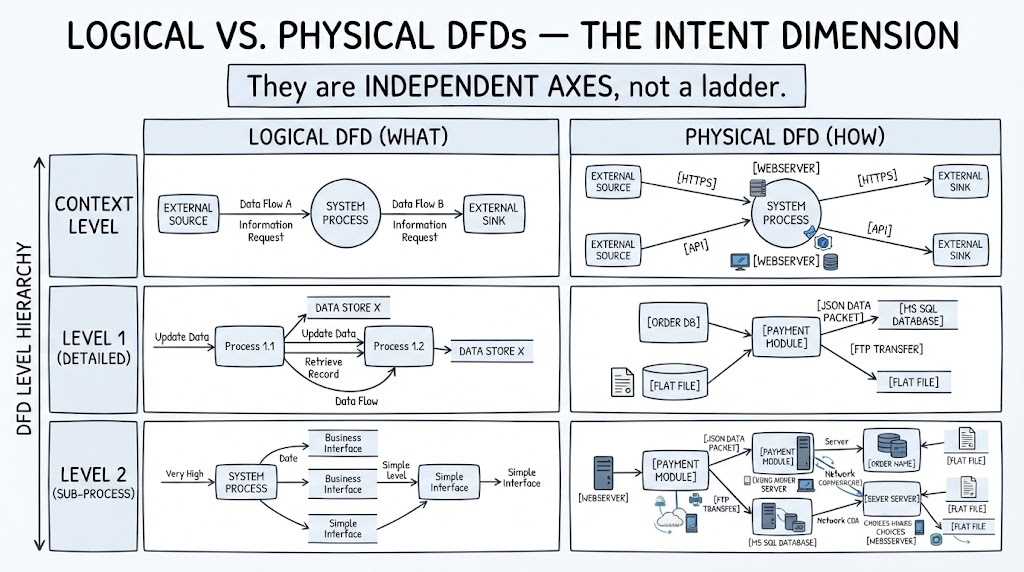
Dies ist die Achse, die Sie zutreffend als mit der Terminologie von Klassendiagrammen vermischt gekennzeichnet haben. Lassen Sie uns präzise sein:
-
Klassendiagramme verwenden Konzeptionell/Logisch/Physisch, um Abstraktionsebenen eines Datenmodells.
-
DFDs verwenden Logisch/Physisch, um Designabsicht — was vs. wie — und dies ist orthogonal zur Ebenenhierarchie.
Das bedeutet dass jedes Niveau (Kontext, Ebene 1, Ebene 2) entweder als logische DFD oder als physische DFD gezeichnet werden kann. Sie sind unabhängige Achsen, keine Leiter.
3.1 Logische DFD — Was das System tut
| Aspekt | Detail |
|---|---|
| Fokus | Geschäftsanforderungen und was das System erreichen muss – ohne Implementierungsvoreingenommenheit. |
| Ignoriert bewusst | Hardware, Software, Datenbanken, Abteilungen, manuell vs. automatisiert, Dateiformate, Zeitplanung. |
| Verwendet in | Anforderungsanalyse und Geschäftsmodellierung. |
Vergleichen Sie dies Logische die logische DFD-Mitgliedschaft mit der physischen, die direkt darunter steht. Dasselbe System, dasselbe Niveau – aber die logische benennt keine Technologien und keine spezifischen Abteilungen, nur Geschäfts- Aktivitäten und konzeptionelle Datenspeicher:
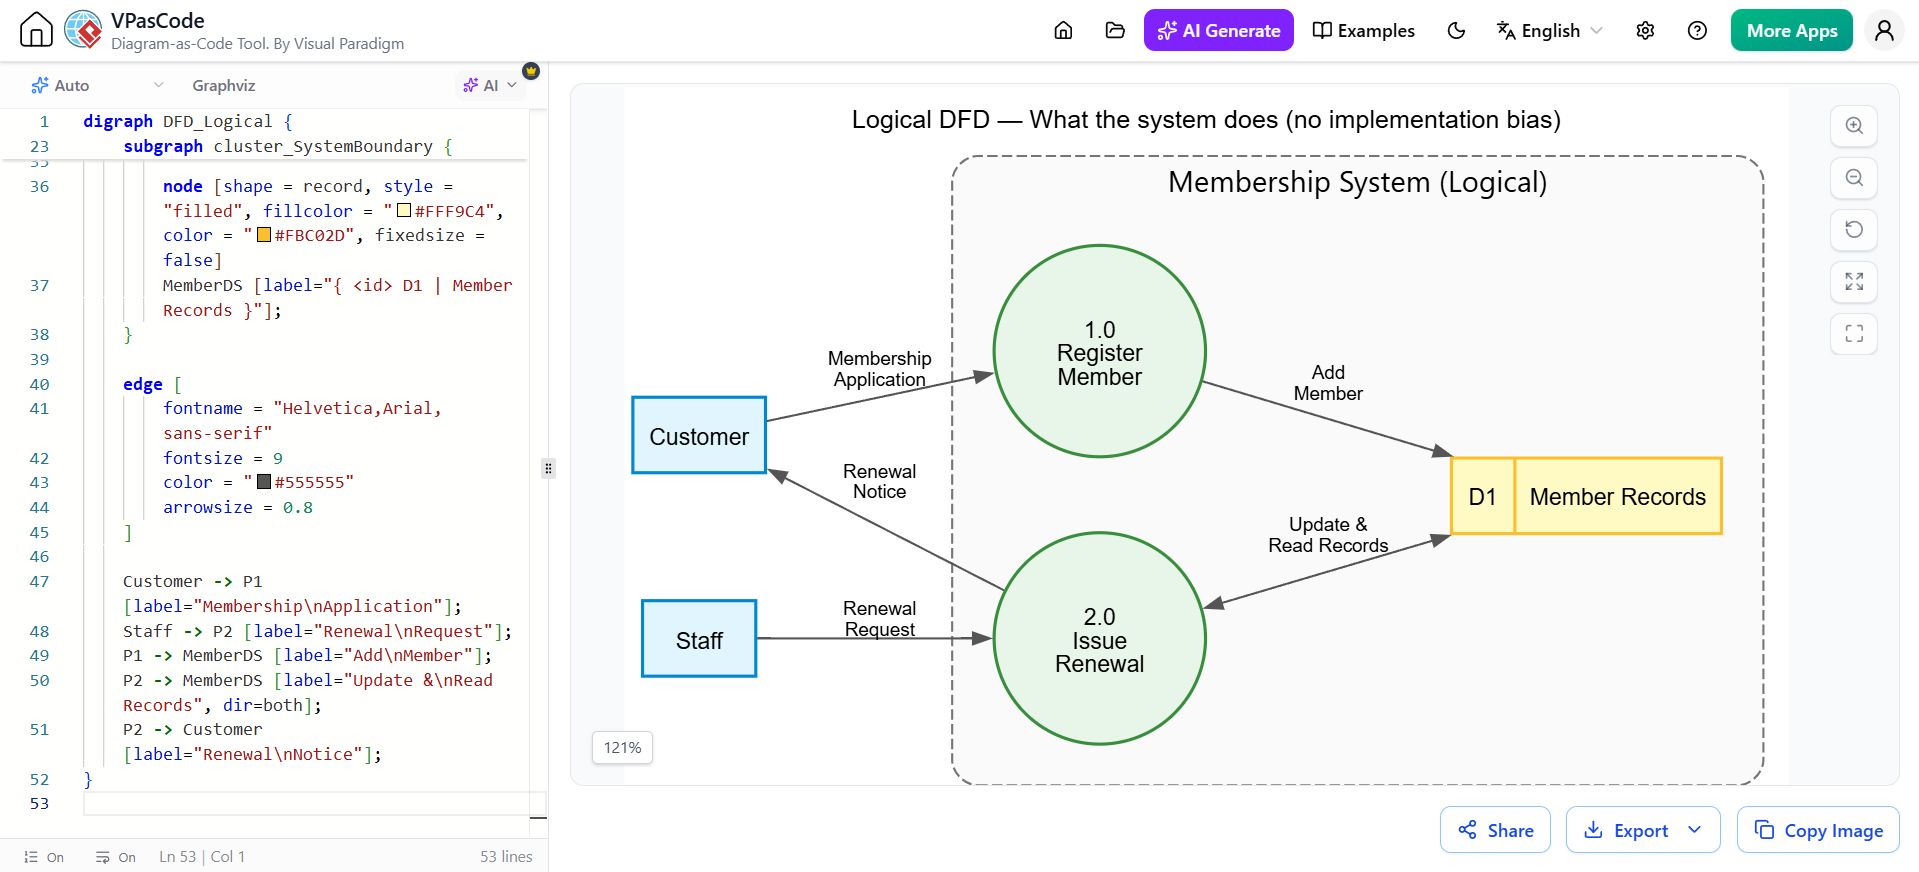
digraph DFD_Logical {
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Logische DFD — Was das System tut (keine Implementierungsvoreingenommenheit)"
        labelloc = t
    ]

    node [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 11
        penwidth = 1.5
    ]

    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Customer; Staff;

    subgraph cluster_SystemBoundary {
        label = "Mitgliedschaftssystem (Logisch)";
        fontname = "Helvetica,Arial,sans-serif; bold"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        node [shape = circle, style = "filled", fillcolor = "#E8F5E9", color = "#388E3C", fixedsize = true, width = 1.4]
        P1 [label="1.0nMitgliednanmelden"];
        P2 [label="2.0nVerlängerungnausstellen"];

        node [shape = record, style = "filled", fillcolor = "#FFF9C4", color = "#FBC02D", fixedsize = false]
        MemberDS [label="{ <id> D1 | Mitgliederaufzeichnungen }"];
    }

    edge [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 9
        color = "#555555"
        arrowsize = 0.8
    ]

    Customer -> P1 [label="Mitgliedschaftsnantrag"];
    Staff -> P2 [label="Verlängerungsnanfrage"];
    P1 -> MemberDS [label="Mitgliednhinzufügen"];
    P2 -> MemberDS [label="Aufzeichnungennaktualisieren &nlesen", dir=both];
    P2 -> Customer [label="Verlängerungsnbenachrichtigung"];
}
3.2 Physische DFD — Wie das System implementiert wird
| Aspekt | Detail |
|---|---|
| Fokus | Die konkrete Realisierung des logischen Modells: spezifische Technologien, Datei-/DB-Namen, Personen, Abteilungen, Hardware, Zeitplanung, Protokolle. |
| Enthält | DBMS- und Schema-Namen, Nachrichtenwarteschlangen, APIs & Protokolle (HTTPS, JSON, JDBC, JMS), Personen und Abteilungen, Automatisierungsoptionen. |
| Verwendet in | Systemdesign und Implementierungsplanung. |
Das gleiche Mitgliedersystem, nun als physisches DFD — beachten Sie, dass der Prozess 1.0 zu einem Registrierungsdienst (Server) wird der Datenspeicher zu MySQL members_db, eine E-Mail-Warteschlange erscheint, und Flüsse werden mit konkreten Protokollen beschriftet:
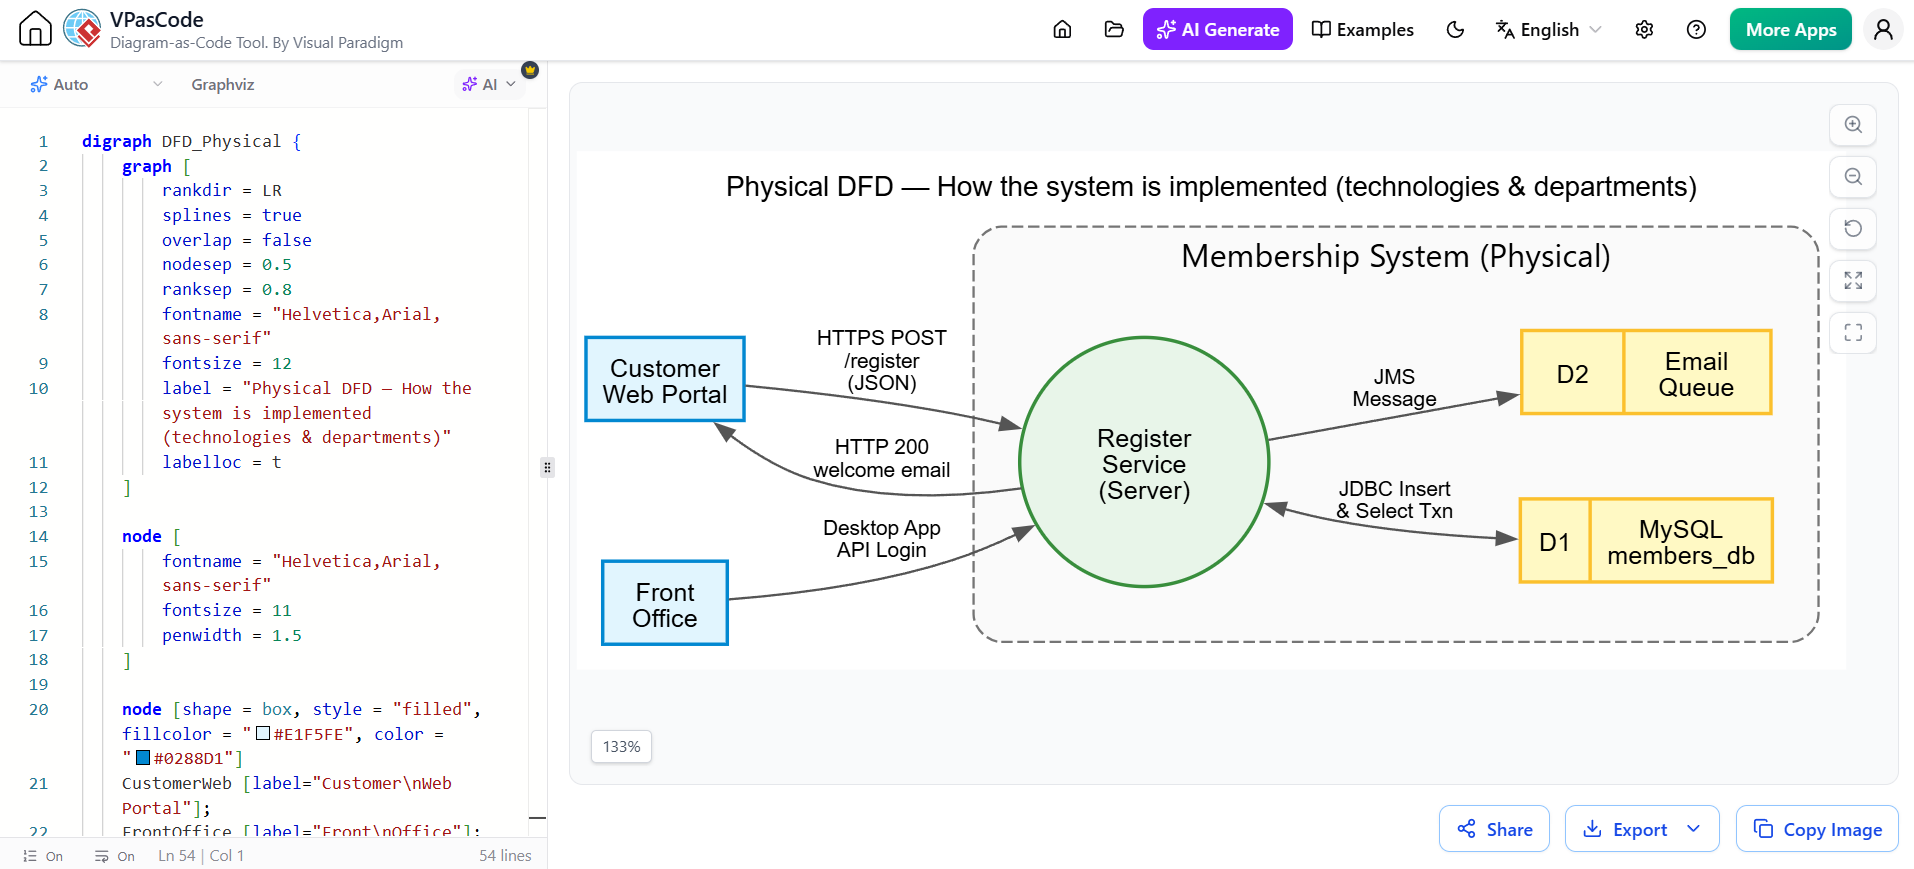
digraph DFD_Physical {
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Physisches DFD — Wie das System implementiert wird (Technologien & Abteilungen)"
        labelloc = t
    ]

    node [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 11
        penwidth = 1.5
    ]

    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    CustomerWeb [label="KundennWebportal"];
    FrontOffice [label="FrontnOffice"];

    subgraph cluster_SystemBoundary {
        label = "Mitgliedersystem (Physisch)";
        fontname = "Helvetica,Arial,sans-serif; bold"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        node [shape = circle, style = "filled", fillcolor = "#E8F5E9", color = "#388E3C", fixedsize = true, width = 1.5]
        SRV [label="RegistrierungnDienstn(Server)"];

        node [shape = record, style = "filled", fillcolor = "#FFF9C4", color = "#FBC02D", fixedsize = false]
        MySQLDS [label="{ <id> D1 | MySQLnmembers_db }"];
        QueueDS [label="{ <id> D2 | E-MailnWarteschlange }"];
    }

    edge [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 9
        color = "#555555"
        arrowsize = 0.8
    ]

    CustomerWeb -> SRV [label="HTTPS POSTn/registern(JSON)"];
    FrontOffice -> SRV [label="Desktop-AppnAPI-Login"];
    SRV -> MySQLDS [label="JDBC Insertn& Select Txn", dir=both];
    SRV -> QueueDS [label="JMSnNachricht"];
    SRV -> CustomerWeb [label="HTTP 200nWillkommens-E-Mail"];
}
Fazit: Ein reifes Projekt erstellt zunächst logische DFDs (Kontext bis Ebene 2) während der Anforderungserhebung, damit Stakeholder die Korrektheit des Verhaltens ohne technisches Rauschen überprüfen können, und leitet daraus physische DFDs ab während des Designs — wenn das „Was“ vereinbart ist, kann das „Wie“ darauf aufgesetzt werden. Die Ebenen bleiben parallel: Ihre physische Ebene 1 spiegelt Ihre logische Ebene 1 wider, angereichert mit Implementierungsdetails.
4. Abbildung von DFD-Ebenen auf die Klassen-Diagramm-Abstraktion
Wenn Sie bereits in Begriffen der Klassen-Diagramm-Abstraktion denken, ist dies eine annähernde (und nützliche, aber unvollkommen) Brücke:
| Klassendiagramm-Konzept | ≈ DFD-Äquivalent |
|---|---|
| Konzeptionell Klassendiagramm (Geschäftsebene-Verständnis) | Kontextdiagramm oder Logisches DFD der Ebene 1 |
| Logisch Klassendiagramm (detaillierte funktionale Spezifikation) | Logisches DFD der Ebene 2+ |
| Physisch / Implementierung Klassendiagramm (technologie-spezifisches Design) | Physisches DFD |
Hinweis: Diese Zuordnung dient der mentalen Modellierung und ist keine formale Äquivalenz. Wie Sie angemerkt haben, ist die autoritative Terminologie in der Literatur zur Systemanalyse (DeMarco, Gane & Sarson, Yourdon) ist strikt Kontext, Ebene 1, Ebene 2… zusammen mit der orthogonalen Logisch/Physisch Unterscheidung.
5. Die kritischen Qualitätsregeln für DFDs
Dies sind die Invarianten, die ein professionelles, ausgewogenes DFD von einem schlampigen trennen:
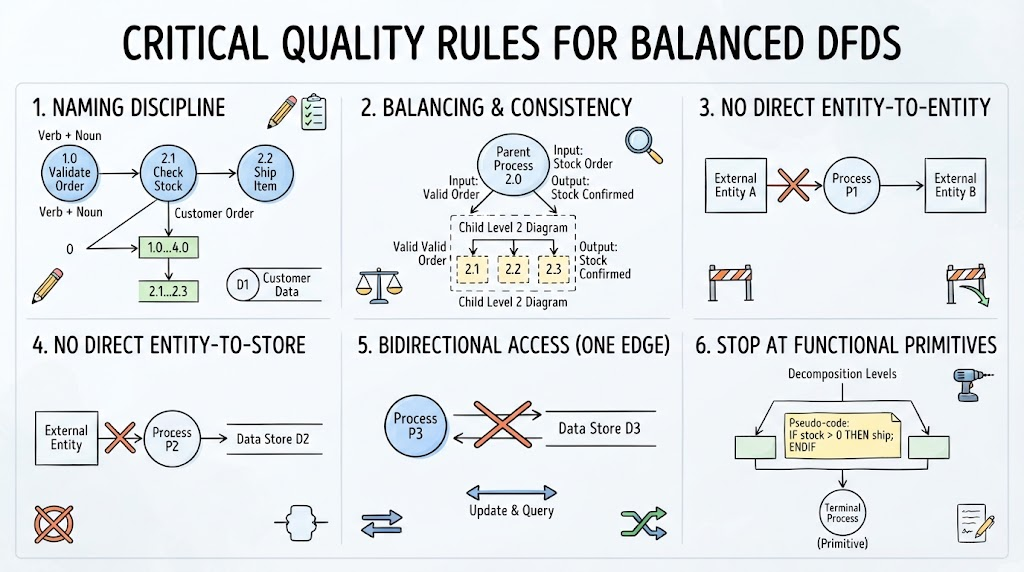
-
Namensdisziplin. Jeder Prozess hat ein Verb + ein Substantiv, ist nummeriert, und die Nummerierung bildet einen strengen Baum (
0→1.0…4.0→2.1…2.3). Jeder Datenspeicher ist nummeriertD1,D2, … Jeder Fluss hat eine beschreibende Beschriftung. -
Ausgewogenheit (Konsistenz über Ebenen hinweg). Die Eingaben und Ausgaben eines übergeordneten Prozesses müssen exakt übereinstimmen die kombinierten Eingaben und Ausgaben seiner untergeordneten Prozesse. Wenn der Prozess
2.0empfängtGültige Bestellungund gibt zurückLagerbestand bestätigtmuss das Level-2-Diagramm, das2.0muss akzeptierenGültige Bestellungund muss erzeugenLagerbestand bestätigt— nichts mehr, nichts weniger. Dies ist die wichtigste Regel beim Zerlegen. -
Keine direkten Flüsse von Entität zu Entität.Daten fließen immer durcheinen Prozess. Externe Entitäten verbinden sich niemals direkt miteinander oder mit Datenspeichern.
-
Keine direkten Flüsse von Entität zu Speicher.Externe Entitäten interagieren mit Speichern ausschließlich über einen Prozess (in der DeMarco/Yourdon-Konvention ist dies eine strengeRegel).
-
Zweiseitiger Zugriff ist eine Kante.Wenn zwei Elemente Daten in beide Richtungen austauschen (typisch bei Datenspeichern), zeichnen Sie einen einen einzigen Pfeilmit
dir=bothund ein zusammengeführtes Label ("Aktualisieren & Abfragen"), nicht zwei separate einseitige Pfeile — das hält das Diagramm übersichtlich und lesbar. -
Hören Sie bei funktionalen Primitiven auf.Zerlegen Sie nur so tief wie nötig; die Endprozesse sollten in wenigen Zeilen Pseudocode beschreibbar sein.
6. In diesen Diagrammen verwendete visuelle Konventionen
Alle obigen Beispiele folgen dem Standard-Modern-DFD-Styling, das in Graphviz sauber gerendert wird:
-
Externe Entitäten — hellblaue Kästen mit blauen Rändern (
#E1F5FE/#0288D1). -
Prozesse — grüne Kreise mit grünen Rändern (
#E8F5E9/#388E3C), nummeriert und mit Verben benannt. -
Datenspeicher — gelbe Balken im Stil von Datensätzen (
#FFF9C4/#FBC02D) beschriftet mit ID + Name (D2 | Lagerbestand). -
Systemgrenze — ein gestrichelter, abgerundeter Container (Cluster) mit hellem Hintergrund (
#FAFAFA) und grauer Rahmen (#757575). -
Kanten — mittelgrau (
#555555), kleine Pfeilköpfe, achsenausgerichtete Verläufe über diePunktEngine.
7. Checkliste vor der Präsentation eines DFD
Verwenden Sie dies als Selbstüberprüfungsgrenze, bevor Sie ein DFD als abgeschlossen:
-
Ist das Niveau klar angegeben (Kontext / Ebene n)? Ist der Nummerierungsbaum konsistent mit dem übergeordneten Element?
-
Werden alle vier Symboltypen korrekt verwendet, mit den richtigen Benennungsmustern?
-
Ist das Diagramm ausgewogen gegen seine übergeordnete Entität (Eingangs- und Ausgangsflüsse stimmen exakt überein)?
-
Sind alle Flüsse mit aussagekräftigen Datenbeschreibern beschriftet?
-
Werden bidirektionale Speicher/Lieferanten-Flüsse zu einzelnen
dir=bothKanten zusammengefasst? -
Sind Grenz- und externe Entitäten frei von direkten Entität↔Entität- / Entität↔Speicher-Flüssen?
-
Erfüllt jeder Blattprozess die Kriterien eines funktionalen Primitivs?
8. Zusammenfassung
-
Hierarchie = Ebenen. Kontext (Ebene 0) → Ebene 1 → Ebene 2 → … Jede Ebene zerlegt einen Prozess in feinere Teilprozesse, bis funktionale Primitive erreicht werden.
-
Absicht = Logisch vs. Physisch. Logische DFDs beantworten was; Physische DFDs beantworten wie. Die beiden Achsen sind orthogonal — jede Ebene kann auf beide Arten dargestellt werden.
-
Nennen Sie DFD-Ebenen nicht „konzeptionell/logisch/physisch“. Das sind Begriffe aus dem Klassenmodell. In der formalen Systemanalyse (DeMarco, Gane & Sarson, Yourdon) ist die korrekte Terminologie Kontext / Ebene 1 / Ebene 2 plus die Logisch/Physisch Unterscheidung.
-
Best Practice: erstellen Sie logische DFDs durch Ebene 0–2 während der Analyse, um Anforderungen zu fixieren, und erstellen Sie dann Physikalische DFDs ableitenwährend des Designs, um die Implementierung zu planen.
Die vier oben gezeigten Graphviz-Diagramme („Kontext, Ebene 1, Ebene 2 und das Logisch/Physikalische-Paar) zeigen den vollständigen Fortschritt. Jedes wird direkt aus den Code-Blöcken gerendert – Sie können jeden davon in Graphviz kopieren, um das gerenderte Ergebnis zu sehen.
Fazit
Literaturhinweise
- Meisterung von Datenflussdiagrammen: Vom manuellen Zeichnen zur KI-gestützten Modellierung mit Visual Paradigm: Ein umfassender Leitfaden, der DFD-Grundlagen, Schritte zur manuellen Erstellung und den innovativen KI-gestützten Modellierungsworkflow mit dem VP AI Chatbot abdeckt.
- Meisterung von Datenflussdiagrammen: Ein umfassender Leitfaden zur KI-gestützten Top-Down-Zerlegung mit Visual Paradigm: Dieser Blogbeitrag geht tief auf die Nutzung der KI von Visual Paradigm für die Top-Down-Zerlegung ein und zeigt, wie man DFDs der Ebene 1, 2 und 3 konversationell generiert.
- Meisterung von Datenflussdiagrammen mit Visual Paradigm: Ein Schritt-für-Schritt-Leitfaden: Ein offizieller Leitfaden, der ein praktisches, schrittweises Tutorial zur Erstellung von DFDs bietet, beginnend mit Vorlagen und unter Verwendung realer Beispiele wie eines Online-Shops.
- Erstellung von DFDs mit Visual Paradigm Desktop: Ein praktischer Leitfaden, der sich auf die Desktop-Version konzentriert und erklärt, wie man ein Projekt erstellt, Kontext- und Ebene-1-Diagramme zeichnet und die Zerlegungsfunktion verwendet.
- Meisterung von DFD-Ebenen und dem Ausgleich: Eine Ressource, die das kritische Konzept des Ausgleichs von Datenflussdiagrammen über verschiedene Ebenen hinweg behandelt, um Konsistenz und Genauigkeit in der Systemanalyse sicherzustellen.
- Einsteigerleitfaden zu Datenflussdiagrammen (DFD) mit Visual Paradigm Online: Ein einsteigerfreundlicher Leitfaden, der DFD-Konzepte einführt und eine einfache, schrittweise Anleitung zur Erstellung von Diagrammen mit der Online-Version von Visual Paradigm bietet.
- Beispiele für Datenflussdiagramme: Eine wertvolle Ressourcenseite, die eine Sammlung von DFD-Beispielen für verschiedene Systeme wie ein Bestellsystem für Lebensmittel, eine Supermarkt-App und ein Lagerverwaltungssystem bietet, die als Referenzmodelle verwendet werden können.